| 收益維度 | 量化說明 |
|---|
| 查詢擴展性 | 1 億筆掃描 → 50 分區各掃 200 萬,線性縮短回應時間 |
| 突破架構上限 | V8 非分區表上限 64GB(4K)/512GB(32K) → 分區後乘以 N;32-bit 記憶體限制亦可透過分區繞過 |
| 載入效能 | 並行 LOAD 所有分區,單表載入時間大幅縮減,關鍵於即時 BI |
| 維護加速 | CREATE INDEX、RUNSTATS、REORG 僅在分區資料子集執行,並行完成 |
| 備份/還原 | 各分區獨立並行備份,整體備份窗口大幅壓縮 |
| 日誌吞吐 | 各分區獨立寫日誌,高並發 DML 時總吞吐線性增長 |
提醒:收益大小取決於工作負荷類型、最大表大小、分區鍵選擇等因素,需以原型驗證。
何時適合、何時不適合採用 DPF
✅ 理想場景
- 大表全掃描聚合:
SELECT COUNT(*) FROM big_table — 各分區算小計,通訊成本可忽略
- 大表 Join 少量小表:大表分區,小表複寫到每分區(Collocated Join),零資料移動
❌ 避免場景
- Ad-hoc 多大表 Join:難以單一分區鍵滿足所有 Join,產生大量分區間資料重分配
- 大量極小語句:分區間通訊開銷 > 本地執行時間,響應時間惡化(特別是跨物理機)
🔄 灰色地帶
大多數真實負載介於兩極之間,必須以原型測試驗證分區鍵選擇與工作負載適配度。
實戰部署:InfoSphere Balanced Warehouse E7100 (AIX) 完整流程
架構模組
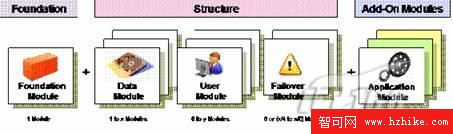
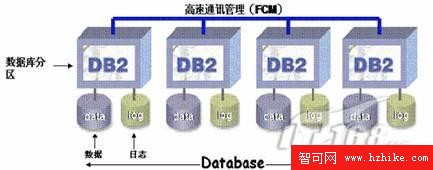
- Foundation Module (Admin BCU):編目分區、協調分區、單分區表,系統僅需 1 個
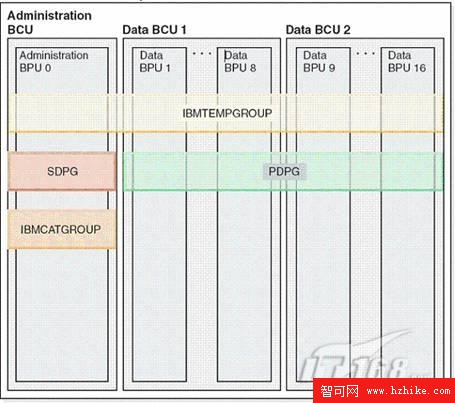
- Data Module (Data BCU):分區表資料,依資料量擴展 1~N 個
- User Module:大量用戶接入時擴展
- Failover Module:高可用備援
- Application Module:跑 ETL 等應用程式
步驟 1:建立實例與通訊設定
# 建立實例(bcufenc 為 fenced user,bcuaix 為實例擁有者)
/opt/IBM/db2/V9.1/instance/db2icrt -u bcufenc bcuaix

# 啟用 TCP/IP
db2set DB2COMM=tcpip

# 設定服務名稱(對應 /etc/services)
db2 update dbm config using svcename xbcuaix

# 實例級停用 Fault Monitor(BW 環境建議)
db2fm -i bcuaix -f no
步驟 2:診斷日誌目錄外置(避免 NFS 爭用)
# 各節點建立獨立目錄於外部存儲
mkdir -p /db2path/bcuaix/NODE0000/SQL00001/db2dump   # Admin BCU
mkdir -p /db2path/bcuaix/NODE0001/SQL00001/db2dump   # Data BCU 1
mkdir -p /db2path/bcuaix/NODE0009/SQL00001/db2dump   # Data BCU 2

# 建立符號連結並指向 diagpath
ln -s /db2path/bcuaix/NODE0000/SQL00001/db2dump /db2path/bcuaix/db2dump
ln -s /db2path/bcuaix/NODE0001/SQL00001/db2dump /db2path/bcuaix/db2dump
ln -s /db2path/bcuaix/NODE0009/SQL00001/db2dump /db2path/bcuaix/db2dump

db2 update dbm config using diagpath /db2path/bcuaix/db2dump
步驟 3:定義資料庫分區 (db2nodes.cfg)
db2nodes.cfg 位於實例主目錄 sqllib/,格式:
0  hostname0  0
1  hostname1  0
9  hostname9  0
- 欄位:
節點號 主機名 邏輯端口號
- 本例:節點 0 (Admin)、1、9 (Data) 分布於不同主機
- 邏輯端口 0 表示使用
svcename 定義的基準埠號
步驟 4:建立資料庫與表空間規劃
# 連接協調節點建庫
db2 "create database bwdb on /db2data dbpartitionnum (0)"

# 規劃表空間:單分區表放 Admin 節點,分區表跨 Data 節點
db2 "create regular tablespace admin_ts in database partition group ibmdefaultgroup"
db2 "create regular tablespace data_ts in database partition group ibmdefaultgroup"

# 重要:小型維度表用 DISTRIBUTE BY REPLICATION 複寫到所有分區
db2 "create table dim_region (...) distribute by replication"
db2 "create table fact_sales (...) distribute by hash (region_id)"
步驟 5:驗證分區運作
# 檢查分區狀態
db2pd -db bwdb -partitions

# 測試查詢分區消除
db2 "explain plan for select * from fact_sales where region_id = 10"
# 應顯示僅存取對應分區
分區管理日常運維指令速查
| 任務 | 指令/方法 |
|---|
| 啟動/停止所有分區 | db2start / db2stop(協調節點發出) |
| 啟動/停止特定分區 | db2start dbpartitionnum 1 / db2stop dbpartitionnum 1 |
| 新增分區 | db2start dbpartitionnum 5 add dbpartitionnum → 再 REDISTRIBUTE |
| 移除分區 | db2stop dbpartitionnum 5 drop dbpartitionnum verify |
| 重新分布資料 | REDISTRIBUTE DATABASE PARTITION GROUP ibmdefaultgroup UNIFORM |
| 查看分區資料傾斜 | db2 "select dbpartitionnum(rid), count(*) from fact_sales group by dbpartitionnum(rid)" |
| 備份所有分區 | db2 backup database bwdb on all dbpartitionnums |
| 還原單分區 | db2 restore database bwdb on dbpartitionnum 1 |
分區鍵選擇黃金法則
- 高基數:唯一值越多,資料越均勻
- 常用 Join/Group By 欄位:實現 Collocated Join,避免重分配
- 避免熱點:單一值佔比過高導致資料傾斜
- 小表用複寫:維度表
DISTRIBUTE BY REPLICATION,Join 時零移動
Windows 環境差異提醒
- 分區間通訊用 Named Pipe / TCP/IP,需在
DB2NODE 環境變數切換節點
db2ncrt/db2ndrop 管理邏輯分區(而非 AIX 的 db2nodes.cfg 直接編輯)- 其餘 SQL 管理指令(REDISTRIBUTE、備份等)跨平台一致
總結:從架構理解到落地交付
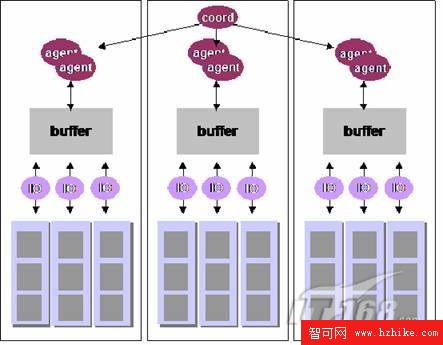
DB2 DPF 以 Share-Nothing 架構提供近線性擴展,核心在於:
- 正確識別適用場景(大表掃描/聚合、大表 Join 小表複寫)
- 科學選擇分區鍵(高基數、Join 欄位、避免熱點)
- 善用混合部署(物理 Scale-out + 邏輯 Scale-up)最大化硬體 ROI
- 標準化運維流程(diagpath 外置、db2nodes.cfg 版本化、備份/重分布自動化)
配合 InfoSphere Balanced Warehouse 等參考架構,可將「猜測配置」轉為「可預測、可度量、開箱即用」的企業級數據倉庫交付標準。
- 上一篇文章: DB2 pureXML 不區分大小寫搜尋最佳實踐:Unicode 排序規則讓索引生效
- 下一篇文章: DB2 LOAD FROM CURSOR 實戰:高效跨表空間與跨數據庫數據遷移指南
Copyright ©
程式碼之家 All Rights Reserved