XML 元素/屬性值預設區分大小寫。搜尋 <city>Paris</city> 找不到 PARIS 或 paris。常見對策 fn:upper-case() 雖可行,但導致 XML 索引失效,大數據量下效能崩潰。DB2 9.5 FP1 引入 UCA500R1 區域感知 Unicode 排序規則,從資料庫層面解決大小寫不敏感,並完整保留索引效能。
CREATE TABLE customer (id INTEGER, xmldoc XML);
INSERT INTO customer VALUES
(1, '<Customer id="1"><city>PARIS</city></Customer>'),
(2, '<Customer id="2"><city>Tokyo</city></Customer>'),
(3, '<Customer id="3"><city>tokyo</city></Customer>'),
(4, '<Customer id="4"><city>PARIS</city></Customer>'),
(5, '<Customer id="5"><city>paris</city></Customer>'),
(6, '<Customer id="6"><city>Delhi</city></Customer>'),
(7, '<Customer id="7"><city>Paris</city></Customer>');

-- 傳統做法:轉大寫比對
SELECT id, XMLCAST(XMLQUERY('$XMLDOC/Customer/city') AS VARCHAR(15)) AS city
FROM customer
WHERE XMLEXISTS('$XMLDOC/Customer[fn:upper-case(city) = "PARIS"]');

-- 參數化查詢
WHERE XMLEXISTS('$XMLDOC/Customer[fn:upper-case(city) = fn:upper-case($c)]'
PASSING CAST(? AS VARCHAR(15)) AS "c")缺點:謂詞含函數 → 無法使用 /Customer/city XML 索引 → 全表掃描。
CREATE DATABASE testdb
USING CODESET UTF-8 TERRITORY US
COLLATE USING UCA500R1_LEN_S2;| 片段 | 含義 |
|---|---|
| UCA500R1 | Unicode Collation Algorithm 5.0.0 版本基準 |
| LEN | Language=EN(英語規則),L=Language、EN=ISO 639-1 編碼 |
| S2 | Strength Level 2:忽略大小寫,但區分重音符號 |
Strength Level 對照:
cliche = Cliche = cliché(忽略大小寫+重音)cliche = Cliche < cliché(忽略大小寫,保留重音差異)cliche < Cliche < cliché(完全區分)完整組合請查閱 DB2 Information Center「UCA 排序規則名」。
CREATE INDEX customer_lang_idx ON test (XMLdoc)
GENERATE KEY USING XMLPATTERN '/Customer/city' AS SQL VARCHAR(15);SELECT id, XMLCAST(XMLQUERY('$XMLDOC/Customer/city') AS VARCHAR(15)) AS city
FROM customer
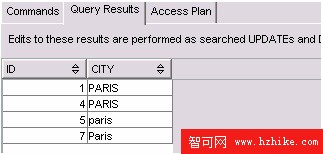
WHERE XMLEXISTS('$XMLDOC/Customer[city = "PARIS"]'); -- 搜尋 "Paris"、"paris" 同樣有效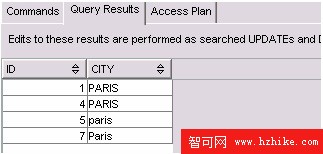
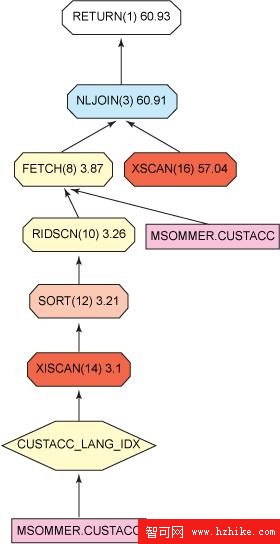
Visual Explain / db2exfmt 明確顯示 IXSCAN 走 customer_lang_idx,無全表掃描。
/Customer/city vs /Customer/City 不同,只影響元素/屬性值PARIS、paris、Paris 視為相等值,排序順序不穩定測試環境:20,000 筆 TPoX CustAcc 文件,對比一般資料庫(區分大小寫)vs 不區分大小寫資料庫。
| 查詢類型 | 效能差異 | ||
|---|---|---|---|
| 少量/中量資料、高選擇性謂詞 | 可忽略不計 | ||
| 全表掃描 + 字串比較(20,000 筆) | 不區分大小寫資料庫 慢 5%~8% |
| 方案 | 適用資料類型 | 索引支援 | 維護複雜度 |
|---|---|---|---|
| UCA500R1_LEN_S2 排序規則 | XML + 關係 | ✅ 完整支援 | 低(一次建庫設定) |
| Generated Column + 一般索引 | 關係欄位 | ✅ | 中(需觸發器/生成欄) |
| fn:upper-case() / fn:lower-case() | XML | ❌ 索引失效 | 低但效能差 |
| 應用層統一轉大小寫寫入 | XML + 關係 | ✅ | 高(侵入業務邏輯) |
COLLATE USING UCA500R1_LEN_S2透過 Unicode 排序規則,DB2 pureXML 終於能像關係欄位一樣,優雅地支援大小寫不敏感搜尋——不再在應用層與索引效能之間兩難。