背景與架構
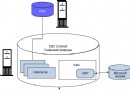
DB2 Parallel Edition (DB2 PE) 運行於 AIX SP2 等共享無(Shared-Nothing)叢集,基於 SN 體系結構與 Function Shipping 模型:將計算下推至數據所在節點,僅傳輸結果集,實現線性擴展。核心組件:
- 服務協調者:解析 SQL、分發子任務、聚合結果;
- 分片策略:Hash 分佈,
CREATE TABLE ... PARTITIONING KEY(col) USING HASHING;
- 並行工具:Load/Import/Reorg/Index/Redistribute 全並行化。
查詢優化三大支柱
- 代價模型:CPU + I/O + 訊息傳遞(網絡),而非單機僅 CPU+I/O;
- 數據分佈感知:利用基表與中間結果的分片信息,優先選擇 Collocated Join(同分片鍵等值連接,無數據移動);
- 透明並行:應用無需改寫 SQL,優化器自動生成並行計劃。
擴展並行操作符
| 操作符 | 功能 |
|---|
| Coordinator | 控制多子任務協同:啟動、同步、聚合、錯誤處理 |
| Send | 單播/廣播發送數據流到目標節點 |
| Receive | Merge(多路有序輸入合併)或 FIFO(無序匯總) |
連接執行策略
| 策略 | 適用場景 | 數據移動 |
|---|
| Collocated Join | 等值連接且分片鍵相同 | 無 |
| Directed Join | 一側分片鍵連接,另一側非分片鍵 | 將外表元組路由到內表分片節點 |
| Broadcast Join | 小表連接大表、非等值連接 | 小表廣播到所有節點 |
| Repartitioned Join | 雙方均非分片鍵連接 | 雙方按連接鍵重新 Hash 分片 |
計劃生成簡化規則
- 自底向上累計各節點資源消耗,取最大值作為響應時間(忽略協調者開銷與多進程干擾);
- 執行節點選擇僅考慮:內表分片節點集、外表分片節點集、少量其他節點,將搜索空間控制在串行的線性倍數內。
全算子並行化覆蓋
- 聚合:局部聚合 → 全局聚合;
GROUP BY 可重分片提升並行度;
- 集合運算:Union/Intersect/Except 採用 Collocated/Repartitioned 策略,支援 N 元 Union;
- DML with Subquery:Insert/Update/Delete 子查詢採用 Collocated/Directed;Update 若修改分片鍵需重分片受影響行;
- 外連接:策略同內連接,但需保留無匹配行的空擴展邏輯;
- 子查詢:結果集通過 Collocated/Directed/Broadcast 發送到外層謂詞計算節點。
子查詢處理四大難點與對策
| 難點 | 描述 | 對策 |
|---|
| 1. 避免逐行啟動 | 相關子查詢若對外層每行單獨執行,開銷巨大 | 去相關化、半連接轉換、緩存子查詢結果 |
| 2. 防止節點序列化 | 多節點產生外層行時,子查詢執行不應導致全局串行 | 分佈式子查詢執行,結果按需路由 |
| 3. 確保結果正確路由 | 外層行分佈在多節點,子查詢結果必須回到對應節點 | 基於相關列的分片感知路由 |
| 4. 謂詞下推 | 將外層過濾條件盡早下推,減少數據傳輸 | 優化器自動下推可安全下推的謂詞 |
嵌套子查詢示例對比
-- 內層無外部引用:僅執行一次
SELECT * FROM t1 WHERE t1.a IN (SELECT b FROM t2 WHERE t2.c = t1.a AND t2.d IN (SELECT b FROM t3 WHERE t3.a = 10));

-- 內層引用外層 t1.f:需針對外層不同值重複執行或重寫
SELECT * FROM t1 WHERE t1.a IN (SELECT b FROM t2 WHERE t2.c = t1.a AND t2.d IN (SELECT b FROM t3 WHERE t3.a = t1.f));
總結
DB2 PE 通過代價模型擴展、分片感知優化、操作符並行化、智能子查詢去相關化,在共享無架構上實現了近線性的查詢擴展性。理解其優化器決策邏輯,有助於 DBA 設計分片鍵、優化棘手查詢、排查性能抖動。