敏感詞過濾技術選型
| 方案 | 原理 | 時間複雜度 | 空間複雜度 | 適用場景 |
|---|
| 暴力遍歷 | 逐詞 contains | O(n×m×k) | O(m) | 詞庫極小(<100) |
| 正則表達式 | 巨大 OR 正則 | O(n) 但常數大 | O(m) | 詞庫中等、模式固定 |
| DFA/Trie 樹 | 有限狀態自動機 | O(n) | O(m×字符集) | 大規模詞庫、高頻調用 |
| AC 自動機 | Trie + 失敗指針 | O(n) | O(m×字符集) | 多模式匹配、需輸出所有匹配位置 |
DFA 算法核心思想
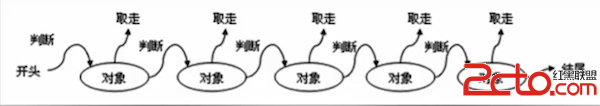
將敏感詞構建為確定性有限自動機 (DFA),文本單次掃描即可完成所有匹配:
- 每個節點代表一個字符狀態
isEnd 標記敏感詞結尾- 遍歷文本時,沿 Trie 邊轉移,命中
isEnd 即發現敏感詞
Java 實現:三層架構設計
1. 敏感詞庫初始化
public class SensitiveWordInit {
    private Map<Character, Object> sensitiveWordMap = new HashMap<>();

    public Map<Character, Object> initKeyWord(Set<String> keyWordSet) {
        for (String key : keyWordSet) {
            Map<Character, Object> nowMap = sensitiveWordMap;
            for (int i = 0; i < key.length(); i++) {
                char c = key.charAt(i);
                Object next = nowMap.get(c);
                if (next == null) {
                    Map<Character, Object> newMap = new HashMap<>();
                    newMap.put('isEnd', "0");
                    nowMap.put(c, newMap);
                    nowMap = newMap;
                } else {
                    nowMap = (Map<Character, Object>) next;
                }
                if (i == key.length() - 1) {
                    nowMap.put("isEnd", "1");
                }
            }
        }
        return sensitiveWordMap;
    }
}
2. 過濾引擎核心邏輯
public class SensitivewordEngine {
    public static Map<Character, Object> sensitiveWordMap;
    public static final int MIN_MATCH = 1; // 最小匹配
    public static final int MAX_MATCH = 2; // 最大匹配(最長)

    // 檢查從 position 開始的敏感詞長度
    public static int checkSensitiveWord(String txt, int position, int matchType) {
        Map<Character, Object> nowMap = sensitiveWordMap;
        int matchFlag = 0;
        boolean isEnd = false;

        for (int i = position; i < txt.length(); i++) {
            char c = txt.charAt(i);
            nowMap = (Map<Character, Object>) nowMap.get(c);
            if (nowMap == null) break; // 無匹配路徑

            matchFlag++;
            if ("1".equals(nowMap.get("isEnd"))) {
                isEnd = true;
                if (matchType == MIN_MATCH) break; // 最小匹配即返回
            }
        }
        return isEnd ? matchFlag : 0;
    }

    // 獲取所有敏感詞
    public static Set<String> getSensitiveWord(String txt, int matchType) {
        Set<String> result = new HashSet<>();
        for (int i = 0; i < txt.length(); i++) {
            int len = checkSensitiveWord(txt, i, matchType);
            if (len > 0) {
                result.add(txt.substring(i, i + len));
                i += len - 1; // 跳過已匹配部分
            }
        }
        return result;
    }

    // 替換敏感詞
    public static String replaceSensitiveWord(String txt, int matchType, String replaceChar) {
        String result = txt;
        Set<String> words = getSensitiveWord(txt, matchType);
        for (String word : words) {
            String replacement = replaceChar.repeat(word.length()); // JDK 11+
            result = result.replaceAll(Pattern.quote(word), replacement);
        }
        return result;
    }
}
3. Service 層整合
@Service
public class SensitiveWordService {
    @Autowired SensitiveWordDao dao;

    @PostConstruct
    public void init() {
        List<SensitiveWord> words = dao.findAll();
        Set<String> wordSet = words.stream()
            .map(SensitiveWord::getContent)
            .map(String::trim)
            .collect(Collectors.toSet());
        SensitivewordEngine.sensitiveWordMap = new SensitiveWordInit().initKeyWord(wordSet);
    }

    public Set<String> filter(String text) {
        return SensitivewordEngine.getSensitiveWord(text, SensitivewordEngine.MAX_MATCH);
    }

    public String replace(String text, String replaceChar) {
        return SensitivewordEngine.replaceSensitiveWord(text, SensitivewordEngine.MAX_MATCH, replaceChar);
    }
}
關鍵優化點
- 構建優化:啟動時異步構建、增量更新(監聽數據庫變更)、序列化緩存到磁盤/Redis
- 查詢優化:位運算壓縮字符集、雙數組實現(base/check)減少對象開銷
- 並發安全:構建完成後只讀,天然線程安全;熱更新用
volatile 引用切換
- 邊界處理:Emoji/補充平面字符(char 不夠用,需
codePointAt)、HTML 標簽干擾(預處理剝離)
替換策略對比
| 策略 | 實現 | 優點 | 缺點 |
|---|
| 固定字符 | *** | 簡單 | 長度洩露信息 |
| 等長替換 | replaceChar.repeat(len) | 長度一致 | 無語義 |
| 語義替換 | 映射表:詞→替換詞 | 可讀性強 | 維護成本高 |
| 高亮標記 | <mark>word</mark> | 前端友好 | 需前端配合 |
生產級建議
- 詞庫分級:核心詞(實時)、次要詞(定時刷新)、白名單(排除誤殺)
- 監控指標:QPS、平均延遲、P99、誤殺率、漏檢率
- 測試用例:邊界字符、重疊詞("中國人" vs "國人")、繁簡體、同音字
- 開源替代:huaban/DFA、baidu/SensitiveWord、Ahocorasick 算法庫