首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 編程語言 >  >> Java 程式設計 >> Java 綜合教學

深入理解字符集與編碼:從 Charset 到 Encoding 的本質區別

     編輯:Java 綜合教學

字符集與編碼:兩個常被混淆的核心概念

在軟體開發中,「字符集」與「編碼」這兩個術語經常被混為一談,但它們代表著完全不同的技術層面。要深入掌握字符處理機制,首先必須建立清晰的概念邊界:

字符集 vs 字符集編碼:接口與實現的關係

  • Charset (Character Set):字符集,定義了系統支援哪些字符及其對應的代碼點(Code Point)
  • Encoding (Charset Encoding):字符集編碼,簡稱編碼,規定如何將代碼點轉換為位元組序列進行存儲或傳輸

這對關係恰似介面與實現類:字符集定義「有哪些字符」(規範),編碼決定「如何表示這些字符」(實現)。同一個字符集可對應多種編碼實現,這正是 Unicode 體系的核心特徵。
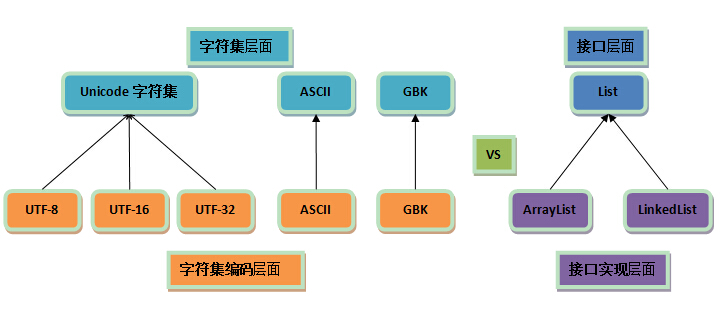
字符集與編碼的接口實現關係圖
字符集與編碼的接口實現關係示意

規範用法對比:HTML vs XML

觀察兩種標準標記語言的聲明方式差異:

<meta http-equiv="content-type" content="text/html;charset=utf-8">
<?xml version="1.0" encoding="UTF-8"?>

XML 的 encoding 屬性更為規範,因為它準確區分了「字符集」與「編碼」概念。HTML 中的 charset=utf-8 易誤導開發者以為存在名為「UTF-8」的字符集,實則 UTF-8、UTF-16、UTF-32 皆為同一字符集(Unicode)的不同編碼實現。

為何必須嚴格區分這兩個概念?

一對一場景:傳統編碼標準

GB2312、BIG5 等早期標準屬於「一字符集一編碼」模式。國家標準制定之初即為統一編碼,單一實現自然無歧義,稱呼混用不會造成實質問題。

一對多場景:Unicode 的特殊性

Unicode 目標是囊括全球所有字符,字符集層面已「最終定型」。但為適應不同場景(兼容 ASCII、平衡空間效率、處理補充平面字符),衍生出 UTF-8、UTF-16、UTF-32 三種編碼。若仍沿用傳統混稱習慣,極易導致技術決策失誤。

核心原則:指定了編碼,其對應的字符集自然確定;編碼才是我們工程實踐中真正需要關注的具體實現。
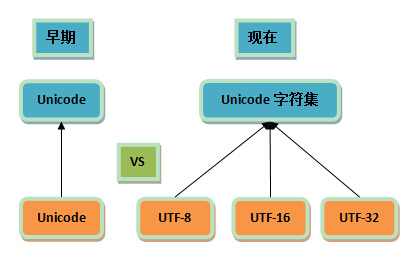
Unicode 歷史演進與常見誤區

Unicode早期與現代架構對比
Unicode 早期架構與現代架構對比

歷史原因導致許多場景下「Unicode」被誤用為特定編碼的代稱:

  • Windows 記事本「另存為」對話框中的「Unicode」實指 UTF-16 LE
  • 早期文檔常將 UCS-2(固定 16 位)等同於 Unicode

嚴格來說,「Unicode」一詞在不同語境下可能指代:

  1. Unicode 標準規範本身
  2. Unicode 字符集(抽象字符集合)
  3. 代碼點(Code Point,抽象編碼數值)
  4. 具體編碼實現(通常指變長的 UTF-16 或早期 UCS-2)

後續章節將深入探討各編碼方案的技術細節與適用場景。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved