前言:為何要重構商品詳情頁?
商品詳情頁是電商網站流量最大、轉化率最高的核心入口。京東商城擁有通用版、全球購、閃購、易車、拼購等數十套模板,雖然元數據一致,但展示邏輯千差萬別。隨著業務爆發式增長,個性化需求激增、數據源極其分散,舊架構已難以支撐「快速響應、優雅解耦」的目標。本文基於 Velocity 2015 大會演講《京東網站單品頁 618 實戰》深度整理,完整復盤京東如何從架構 1.0 進化至 3.0,實現百億流量下服務端響應時間 < 38ms 的極致性能。
一、商品詳情頁的核心挑戰
1. 流量特徵極其特殊
- 離散數據、熱點少:數億 SKU,長尾商品佔多數,難以用傳統熱點緩存覆蓋。
- 爬蟲/比價軟件瘋狂抓取:非真實用戶流量佔比高,需防刷限流。
2. 歷代架構的痛點
| 版本 | 核心技術 | 致命缺陷 |
|---|
| 1.0 |
IIS + C# + SQL Server + Memcached |
強依賴下游服務,一旦依賴抖動,整站跟著抖動 |
| 2.0 (全量靜態化) |
MQ 通知 → Java Worker 生成 HTML → rsync 分發 → Nginx 輸出 |
分類變更需全量重刷;rsync 成瓶頸;模板變更需數天刷新;容量瓶頸導致被迫動態渲染,高峰期拖垮下游 |
| 2.0 改良 (SSI 碎片化) |
按尾號路由分機器 + Nginx SSI 合併片段 |
碎片文件過多無法同步;機械盤 SSI 合併性能差;模板變更仍需全量刷新;動態兜底抗不住峰值 |
二、架構 3.0:需求響應式設計的六大核心原則
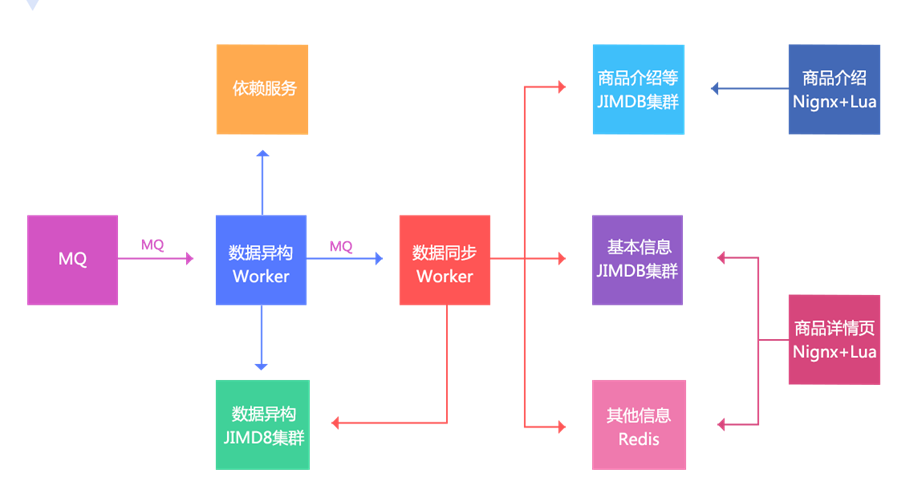
1. 數據閉環:去依賴化,自掌生死
- 數據異構:從各下游系統拉取原始數據,按自身需求存入 JIMDB (Redis + 持久化引擎)。
- 原子化存儲:保留最細粒度字段(標題、屬性、規格、分類、商家等),為後續聚合留足彈性。
- 聚合入庫:按「基本信息」「商品介紹」「其他信息」三維度聚合成大 JSON,前端單次 Get 即可渲染。
- Hash Tag 分片:關聯數據哈希到同一分片,MGET 不跨節點,極致優化讀性能。
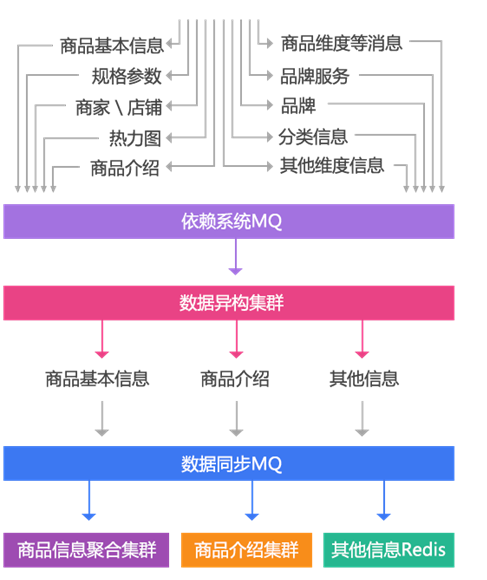
2. 數據維度化:分而治之
| 維度 | 包含數據 | 存儲策略 |
|---|
| 商品基本信息 | 標題、擴展屬性、圖片、顏色尺碼、規格參數 | JIMDB 聚合大值 |
| 商品介紹 | PC/移動端模板、富文本描述 | JIMDB 獨立集群 |
| 非商品維度 | 分類、商家、店鋪、品牌 | 數據量小,直存 Redis |
| 實時異步維度 | 價格、促銷、庫存、配送至、廣告語 | 前端異步 JS 加載,不阻塞首屏 |
3. 系統拆分:職責單一,互不干擾
- 數據異構系統:產出原子數據,對內聚合,對外提供動態服務 (列表頁、對比頁、微信單品頁等)。
- 數據同步/聚合系統:生成前端渲染所需的聚合 JSON,追求極致讀性能。
- 前端展示系統:拆分為「商品詳情頁」與「商品介紹頁」,Nginx + Lua 直讀 JIMDB 渲染模板,互不影響。
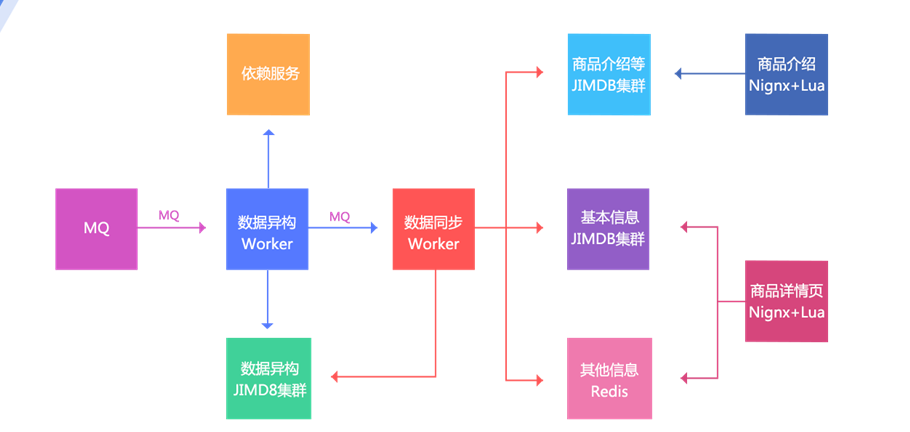
4. Worker 無狀態 + 任務化:橫向擴展無上限
- 異構/聚合 Worker 完全無狀態,配置文件按機房隔離,天然支持多活。
- 任務隊列四層設計:等待隊列 → 排重隊列 → 本地執行隊列 → 失敗隊列。
- 優先級隊列:普通 / 刷數據 / 高優 (秒殺商品走高優,毫秒級生效)。
- 副本隊列:上線 Bug 可回放修復歷史數據。
- 消息按維度拆分 (如基本信息變更、上下架分離),減少無效聚合觸發。
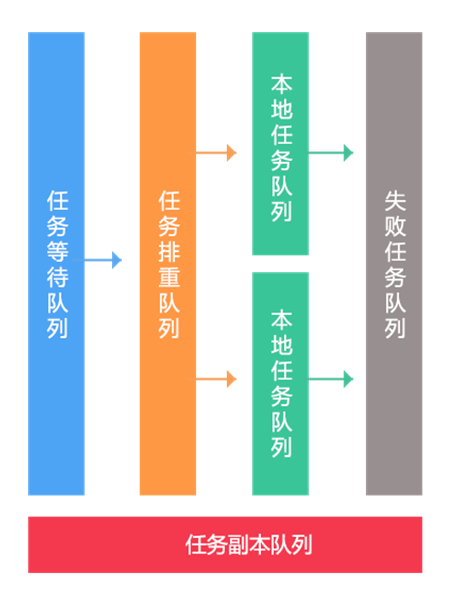
5. 異步化 + 並發化:串行變並行,延遲降 70%
- MQ 解耦:生產者只管發通知,消費者自主拉取聚合。
- 多源並發聚合:原本串行 1s 的調用鏈,並發化後 < 300ms。
- 異步請求合併 & 排重:N 次 RPC 合為 1 次,去重減壓。
- 前端 Nginx + Lua 協程聚合:實時價格、庫存等異步非阻塞獲取。
6. 多級緩存體系:層層過濾,回源率極低
- 瀏覽器 Local Cache:頁面跳轉不請求,Last-Modified 驗證。
- CDN 邊緣節點:就近取數,減少回源帶寬。
- Nginx 共享字典:Lua `shared_dict` 熱數據本地緩存,Reload 不丟失。
- 一致性哈希路由:按 SKU/分類分流,極大提升 Proxy Cache 命中率。
- Local → Remote 兩級 MGET:非商品維度數據 (分類、商家等) 本地緩存 30 分鐘,遠端流量降 50%+。
- JIMDB 分布式存儲:內存 + SSD + LMDB 持久化,單機支撐 TB 級數據。
三、關鍵技術攻關與「踩坑」實錄
1. SSD 選型避雷指南
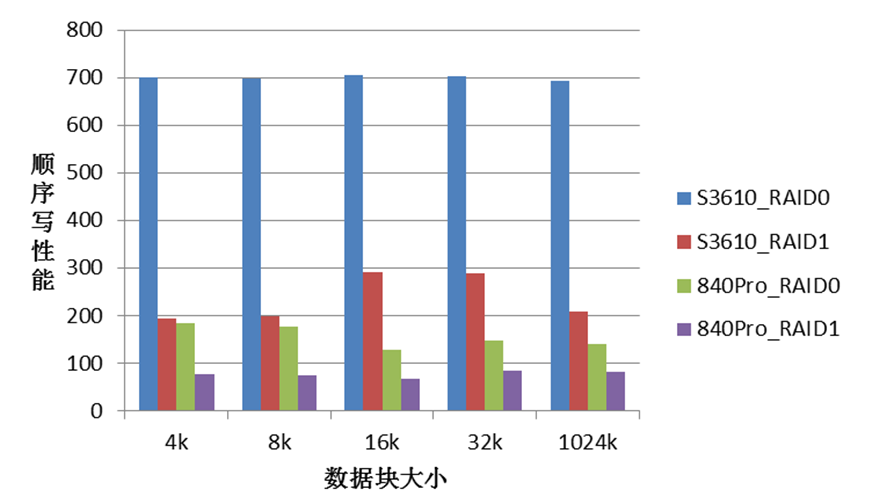
- 消費級三星 840 Pro RAID10 寫入僅 3-6 MB/s,RAID0 達 130 MB/s 但風險大。
- LSI 2008 RAID 卡成性能瓶頸,後改用 Intel S3610/S3710 企業級 SSD + 較新 RAID 卡。
- 生產環境必須用 FIO 做嚴格壓測,切勿信 `dd` 簡單測試。
2. KV 引擎選型:為何最終選 LMDB?
| 引擎 | 讀寫混合表現 | 結論 |
|---|
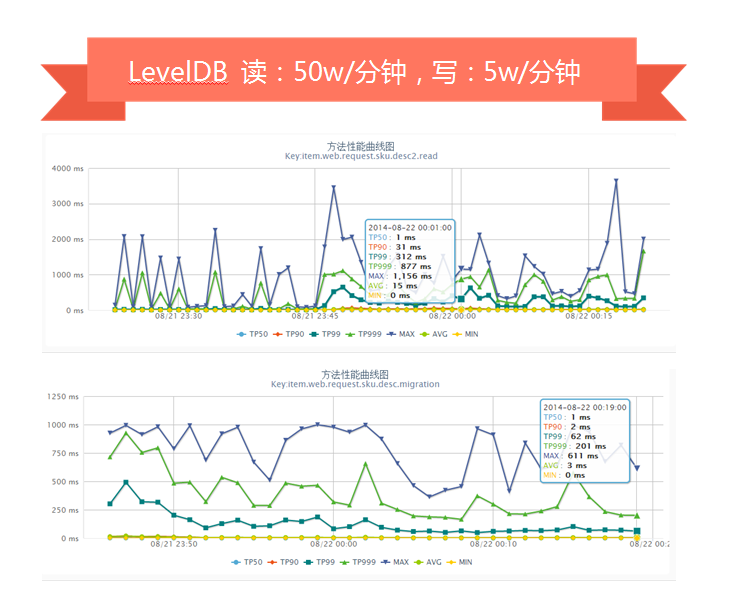
| LevelDB | Compaction 引發嚴重抖動 | ❌ |
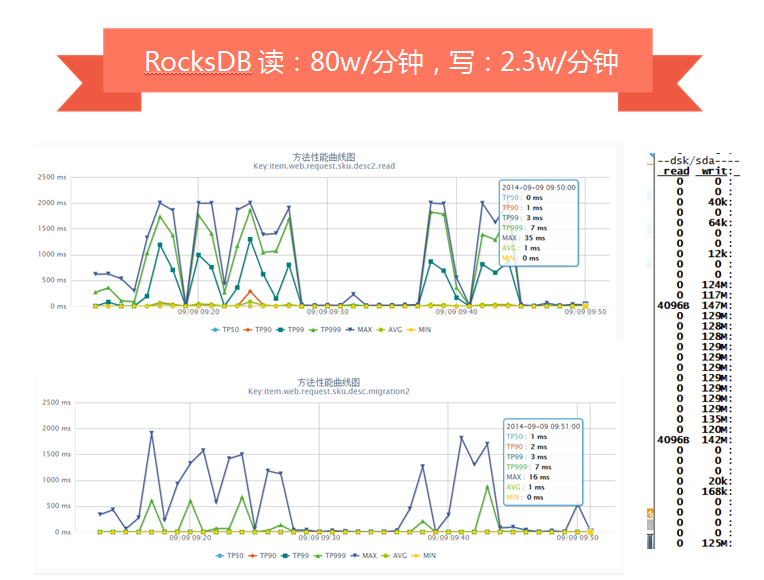
| RocksDB | 單讀/單寫極快,但混合負載下 Merge 導致抖動 | ❌ |
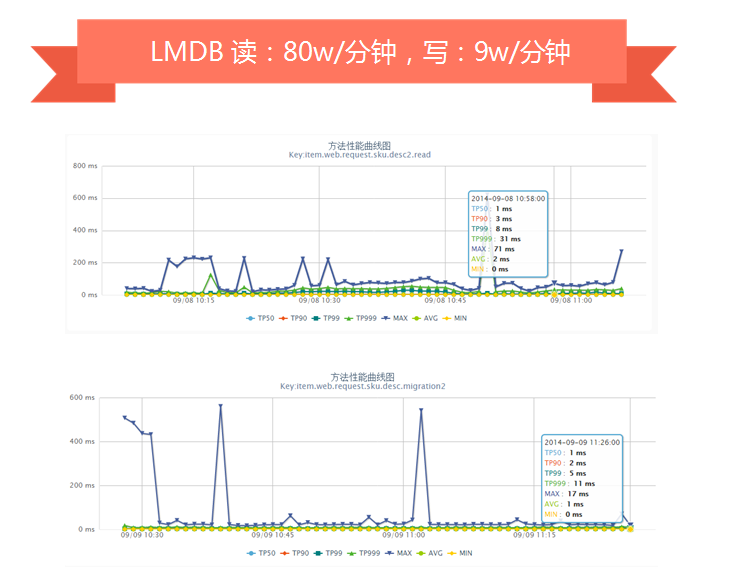
| LMDB | 無明顯抖動,穩定支撐 1.7 億 KV (800GB),Value 5-30KB | ✅ 生產首選 |
3. JIMDB 大數據同步難題
- 單機掛 4 塊 SSD RAID0,啟 8 實例,每實例 ~125GB,Dump 專用 SAS 盤,文件鎖串行 Dump。
- 千兆網卡同步峰值 100MB/s,未來規劃萬兆 + 內存直轉發免 Dump。
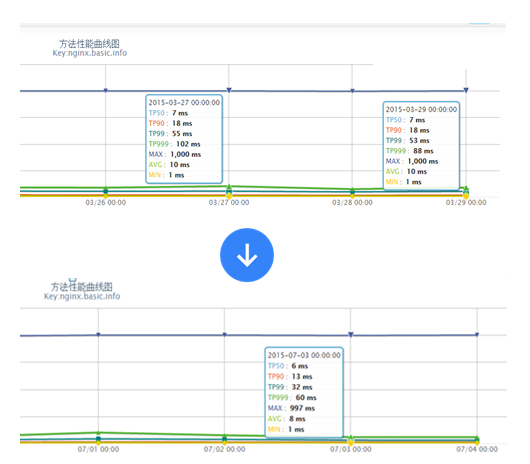
4. 模板渲染:從「存 HTML 片段」回歸「存元數據 + Lua 渲染」
- 早期為省 Lua CPU 存預渲染 HTML,導致模板變更需全量重刷。
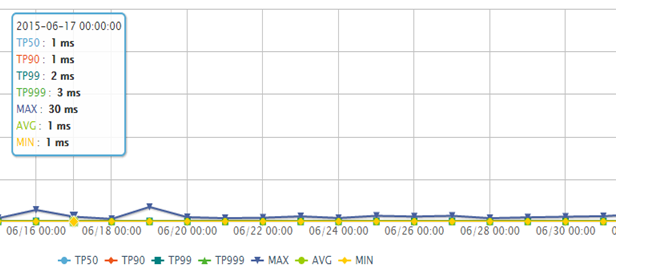
- 壓測證實:Lua 3000+ 行邏輯 + 1500+ 行模板 (大量 for/if) ,TP99 從 53ms 降至 32ms,完全可接受。
5. 經典生產事故及修復
| 事故 | 根因 | 修復方案 |
|---|
| 庫存接口被刷 600w/min,Tomcat 定時重啟 | 詳情頁直連庫存服務無緩存 | Nginx Proxy Cache 緩存數秒,流量瞬間平復 |
| 微信爬蟲遍歷 SKU 導致回源暴增 | 不存在 SKU 穿透到動態服務 | KV 存儲層不限流,回源層嚴格限流 |
| 開啟 Proxy Cache 內存飆升 98% | 內核 LRU 回收不及時 | 調整 `vm.extra_free_kbytes` / `vm.vfs_cache_pressure` + tmpfs/共享字典 |
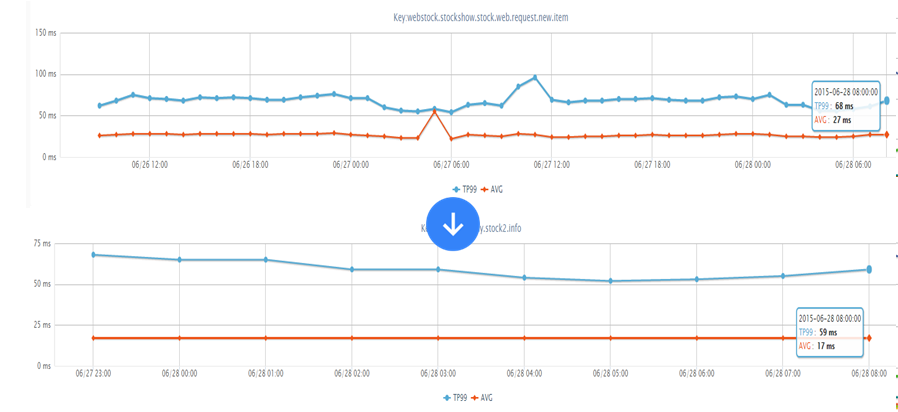
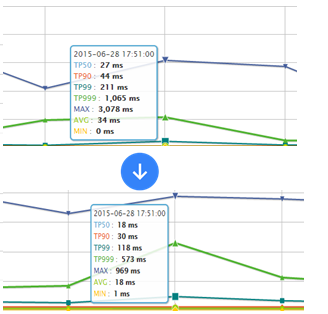
| 配送至服務 TP99 1s+ | 串行調用多個下游 | 並發化 + 預取依賴數據回傳,TP99 降至 118ms |
| 網絡抖動大量 502 | Twemproxy 超時 5s 且未分讀寫 | 內網超時縮至 150ms,分離連接/讀/寫超時,超時走動態服務兜底 |
| 雙 11 接入層網卡 400Mbps、CPU 30% | 所有 Gzip 壓縮集中在接入層 | 壓縮下沉到業務機,Nginx gzip_level 2-4,流量降 5 倍,CPU < 4% |
四、架構總結:十一大設計原則 + 實戰錦囊
- 數據閉環
- 數據維度化
- 拆分系統
- Worker 無狀態 + 任務化
- 異步化 + 並發化
- 多級緩存化
- 動態化 (數據獲取、模板渲染、重啟、上線全動態)
- 彈性化 (Docker 容器化,分鐘級自動擴容)
- 降級開關 (推送下發、多級讀降級、開關前置、線程池隔離)
- 多機房多活 (一主三從,應用無狀態)
- 多種壓測 (線下 ab/jmeter + 線上 tcpcopy 實時流量放大)
運維層面的 15 條「避坑指南」
- Nginx 接入層灰度引流
- 只保留有用請求頭,減少帶寬
- 使用無 Cookie 域名 (c.3.cn) 省流量
- Proxy Cache 僅緩存有效數據,托底數據不緩存
- 非阻塞鎖防緩存擊穿 (`lua-resty-lock` / `proxy_cache_lock`)
- Twemproxy 減少 Redis 連接數
- Unix Domain Socket 替代本機 TCP
- 合理設置連接/讀/寫三級超時
- 長連接減少內部服務握手開銷
- 去數據庫依賴,服務化訪問 (機房域名而非 IP)
- 客戶端同域連接限制 → 域名分片 (c0.3.cn, c1.3.cn),HTTP/2 時代另論
結語:京東單品頁的演進史,本質上是「業務複雜度」與「技術可控度」的博弈史。從強依賴下游的單體應用,到數據自掌、異步解耦、動態渲染的微服務集群,每一步都精準對應業務痛點。沒有銀彈,只有持續演進——這或許是給所有高併發系統架構師最好的啟示。