"abc")自動進入字符串常量池,相同內容共享引用;new String() 強制在堆創建新對象byte[] value + byte coder(Latin-1/UTF-16),節省內存| 功能分類 | 方法簽名 | 說明與示例 |
|---|---|---|
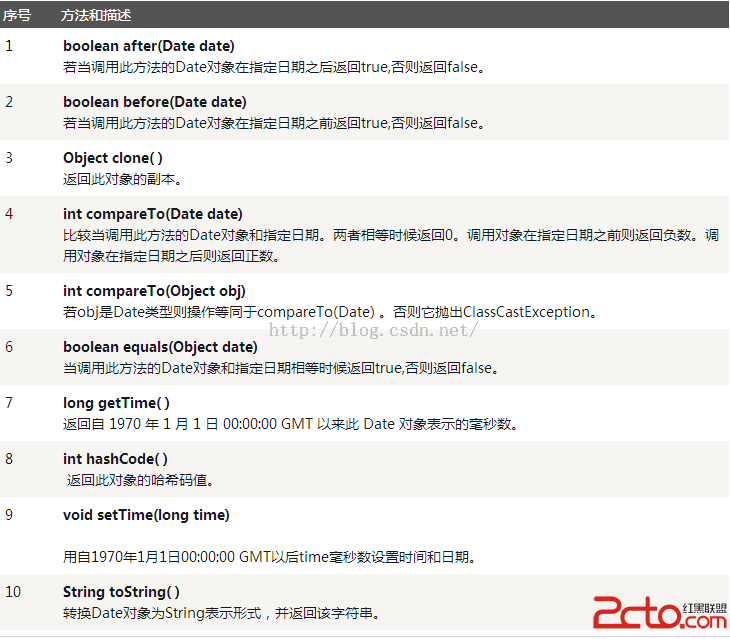
| 長度/訪問 | int length() |
返回字符數(非字節數)。"陶".length() == 1 |
char charAt(int index) |
返回指定索引字符。"abc".charAt(1) == 'b' | |
int codePointAt(int index) |
返回 Unicode 碼點(支持輔助字符/Emoji) | |
| 查找/索引 | int indexOf(String str) |
首次出現索引,不存在返回 -1。"abab".indexOf("ab") == 0 |
int lastIndexOf(String str) |
最後一次出現索引 | |
boolean contains(CharSequence s) |
是否包含子串。"hello".contains("ell") == true | |
boolean startsWith/endsWith(String prefix) |
前綴/後綴匹配 | |
| 子串/截取 | String substring(int begin) |
從 begin 到末尾。"abcde".substring(2) == "cde" |
String substring(int begin, int end) |
左閉右開 [begin, end)。"abcde".substring(1,4) == "bcd" | |
String[] split(String regex) |
正則分割。"a,b,c".split(",") → ["a","b","c"] | |
| 替換/轉換 | String replace(CharSequence old, new) |
字面量替換(非正則)。"abab".replace("a","x") == "xbxb" |
String replaceAll(String regex, String replacement) |
正則替換。"a1b2".replaceAll("\\d","#") == "a#b#" | |
String toLowerCase()/toUpperCase() |
大小寫轉換(Locale 敏感) | |
String trim() / strip() |
去除首尾空白。strip() (Java 11+) 支持 Unicode 空白字符 | |
| 類型轉換 | char[] toCharArray() |
轉字符數組(副本) |
byte[] getBytes(Charset charset) |
編碼為字節數組。"中".getBytes("UTF-8").length == 3 | |
static String valueOf(Object obj) |
任意類型轉字符串。String.valueOf(123) == "123" | |
boolean isEmpty() / isBlank() |
空串/空白串判斷。isBlank() (Java 11+) 判斷只含空白字符 | |
| 比較/匹配 | boolean equals(Object obj) |
內容比較(區分大小寫) |
boolean equalsIgnoreCase(String another) |
忽略大小寫比較 | |
int compareTo(String another) |
字典序比較(實現 Comparable) |
public class StringDemo {
    public static void main(String[] args) {
        String name = "taoshihan陶士涵"; // 混合中英文

        System.out.println("長度: " + name.length());                    // 12
        System.out.println("索引9字符: " + name.charAt(9));             // 陶
        System.out.println("'陶'首次索引: " + name.indexOf("陶"));       // 9
        System.out.println("從索引9截取: " + name.substring(9));        // 陶士涵
        System.out.println("包含'shi': " + name.contains("shi"));       // true
        System.out.println("int轉String: " + String.valueOf(1));        // 1
        System.out.println("toCharArray: " + Arrays.toString(name.toCharArray()));
        System.out.println("UTF-8字節: " + Arrays.toString(name.getBytes("UTF-8")));
        System.out.println("按'n'分割: " + Arrays.toString(name.split("n"))); // [taoshiha, 陶士涵]
        System.out.println("替換'han'→'涵': " + name.replace("han", "涵")); // taoshi涵陶士涵
    }
}| 功能 | Java | PHP | 備註 |
|---|---|---|---|
| 長度 | str.length() | mb_strlen($str, 'UTF-8') | PHP 需指定編碼 |
| 字符訪問 | str.charAt(i) | $str[i] / mb_substr($str,i,1) | PHP 下標訪問不支持多字節字符 |
| 查找索引 | str.indexOf(s) | strpos($str, $s) | PHP 返回 false 而非 -1 |
| 截取子串 | str.substring(i) | mb_substr($str, i) | |
| 包含判斷 | str.contains(s) | strstr($str, $s) !== false | PHP 無直接 contains |
| 轉字符串 | String.valueOf(x) | (string)$x | |
| 分割 | str.split(regex) | explode($sep, $str) | PHP 不支持正則分割(用 preg_split) |
| 替換 | str.replace(old,new) | str_replace($old, $new, $str) |
StringBuilder(非線程安全、高效)或 StringBuffer(線程安全)compile() 緩存,避免重複編譯Locale 避免土耳其語 I/ı 問題:str.toLowerCase(Locale.ROOT)記住:String 不可變是設計精髓,而非缺陷。所有「修改」方法返回新對象,原對象不變。拼接用 StringBuilder,比較用 equals,編碼指定 UTF-8,正則預編譯。