Java 集合框架是 Java 開發中使用頻率最高的 API 之一,深入理解各集合類別的底層資料結構、時間複雜度與適用場景,對於寫出高效能、低記憶體佔用的程式碼至關重要。本文系統整理集合體系架構、核心實現原理與選型決策依據。
Java 集合主要由兩大根介面派生:
List(有序、可重複)、Set(無序、不可重複)、Queue(佇列操作)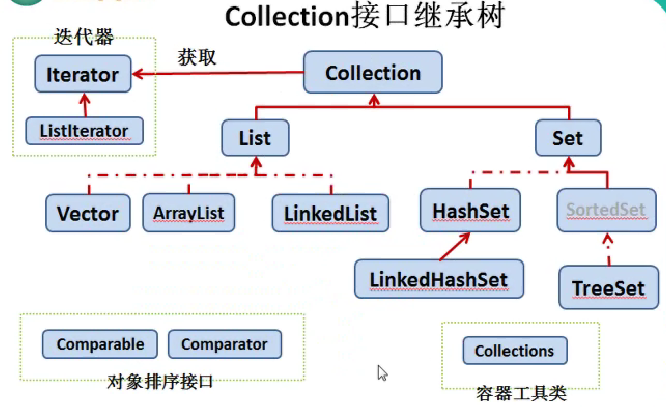
| 實現類別 | 底層結構 | 查詢 | 增刪(頭/尾) | 增刪(中間) | 執行緒安全 | 適用場景 |
|---|---|---|---|---|---|---|
| ArrayList | 動態陣列 | O(1) | O(1)/O(1)* | O(n) | 否 | 頻繁隨機存取、尾部新增 |
| LinkedList | 雙向鏈表 | O(n) | O(1) | O(1) | 否 | 頻繁頭尾操作、佇列/棧 |
| Vector | 動態陣列 | O(1) | O(1)/O(1)* | O(n) | 是(synchronized) | 舊版專案、極少使用 |
| CopyOnWriteArrayList | 陣列+寫時複製 | O(1) | O(n) | O(n) | 是 | 讀多寫少、並發遍歷 |
* ArrayList 擴容時為 O(n),均攤 O(1)
| 實現類別 | 底層結構 | 有序性 | 查詢/新增/刪除 | Null 支援 | 執行緒安全 | 適用場景 |
|---|---|---|---|---|---|---|
| HashSet | HashMap | 無序 | O(1) | 允許一個 | 否 | 去重、快速查找 |
| LinkedHashSet | HashMap+雙向鏈表 | 插入序 | O(1) | 允許一個 | 否 | 保持插入順序去重 |
| TreeSet | 紅黑樹(TreeMap) | 自然序/自訂序 | O(log n) | 不允許 | 否 | 排序去重、範圍查詢 |
| CopyOnWriteArraySet | CopyOnWriteArrayList | 插入序 | O(n) | 允許 | 是 | 並發讀多寫少 |
| ConcurrentSkipListSet | 跳表 | 自然序/自訂序 | O(log n) | 不允許 | 是 | 高並發排序集合 |
| 實現類別 | 底層結構(JDK8+) | 有序性 | 查詢/新增/刪除 | Null Key/Value | 執行緒安全 | 適用場景 |
|---|---|---|---|---|---|---|
| HashMap | 陣列+鏈表/紅黑樹 | 無序 | O(1) | 允許/允許 | 否 | 通用鍵值儲存 |
| LinkedHashMap | HashMap+雙向鏈表 | 插入序/存取序 | O(1) | 允許/允許 | 否 | LRU 快取、保持順序 |
| TreeMap | 紅黑樹 | 自然序/自訂序 | O(log n) | 不允許/允許 | 否 | 排序映射、範圍查詢 |
| Hashtable | 陣列+鏈表 | 無序 | O(1) | 不允許/不允許 | 是(synchronized) | 舊版專案、極少使用 |
| ConcurrentHashMap | CAS+synchronized+紅黑樹 | 無序 | O(1) | 不允許/不允許 | 是(分段鎖) | 高並發鍵值儲存 |
常用集合操作的時間複雜度(n 為元素數量):
ConcurrentHashMapTreeMapLinkedHashMapHashMapArrayListLinkedListTreeSetLinkedHashSetHashSetArrayDeque (非執行緒安全) / ConcurrentLinkedQueueConcurrent* 或 CopyOnWrite* 系列,或使用 Collections.synchronizedXxx() 包裝new ArrayList<>(1000)、new HashMap<>(1024) 避免頻繁擴容/重哈希parallelStream() 僅適合 CPU 密集型大數據量操作掌握集合框架精髓,不在於背誦 API,而在於理解資料結構特性並能根據業務場景做出最優選擇。建議在 Code Review 時重點檢視集合選型是否合理,這往往能發現隱性效能問題。