在嵌入式開發中,為了效率或硬體介面需求,常見「以 byte 陣列直接強轉為結構體指標」或「聯合體搭配位元欄位解析暫存器」的寫法。這類程式碼極度依賴目標 MCU 的大小端模式,移植時極易產生難以察覺的邏輯錯誤。本文透過實測案例,深度剖析兩大經典陷阱。
typedef struct {
    uint16_t m_u1Var1;   // 2 bytes
    uint8_t  reserve[2]; // 2 bytes padding
    uint32_t m_u4Var2;   // 4 bytes
} BlkTest;

uint8_t test_array[8] = {0x01, 0x02, 0x00, 0x00, 0x05, 0x06, 0x07, 0x08};

BlkTest *pblkTest = (BlkTest *)test_array;
uint16_t u2Var1 = pblkTest->m_u1Var1;  // 預期 0x0201
uint32_t u4Var2 = pblkTest->m_u4Var2;  // 預期 0x08070605
Address:  0x20000000  0x20000001  0x20000002  0x20000003  0x20000004  0x20000005  0x20000006  0x20000007
Value:        0x01        0x02        0x00        0x00        0x05        0x06        0x07        0x08
m_u1Var1 佔用 0x20000000 (低位元組) 與 0x20000001 (高位元組) → 值 = 0x0201 ✓m_u4Var2 佔用 0x20000004~0x20000007 → 低→高依序 0x05,0x06,0x07,0x08 → 值 = 0x08070605 ✓m_u1Var1:0x20000000 為高位元組 (0x01)、0x20000001 為低位元組 (0x02) → 值 = 0x0102 ✗m_u4Var2:0x20000004 為最高位元組 (0x05) → 值 = 0x05060708 ✗陣列在記憶體中永遠按索引遞增順序儲存 (index 0 在低位址)。但多位元組整數在記憶體中的位元組序由 CPU 大小端架構決定。強轉指標繞過了編譯器的序列化/反序列化邏輯,直接將原始位元組流依當前架構解讀。
// 明確進行位元組組裝,不依賴大小端
uint16_t u2Var1 = (uint16_t)test_array[1] << 8 | test_array[0];
uint32_t u4Var2 = (uint32_t)test_array[7] << 24 | (uint32_t)test_array[6] << 16 | (uint32_t)test_array[5] << 8 | test_array[4];

// 或使用標準網路位元組序轉換函式 (需包含  或自行實作)
uint16_t u2Var1 = ntohs(*(uint16_t*)&test_array[0]);
uint32_t u4Var2 = ntohl(*(uint32_t*)&test_array[4]);
typedef union {
    uint8_t var;
    struct {
        uint8_t bit0:1; uint8_t bit1:1; uint8_t bit2:1; uint8_t bit3:1;
        uint8_t bit4:1; uint8_t bit5:1; uint8_t bit6:1; uint8_t bit7:1;
    } pixels;
} UnTest;

UnTest unTest;
unTest.var = 0x11; // 二進位 0001 0001
// 預期:bit0=1, bit4=1,其餘=0
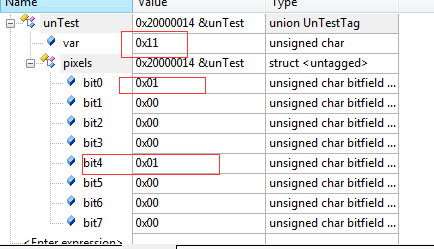
bit0 對應 LSB (第 0 位) = 1 ✓bit4 對應第 4 位 = 1 ✓bit0..bit7 對應位元權重 2⁰..2⁷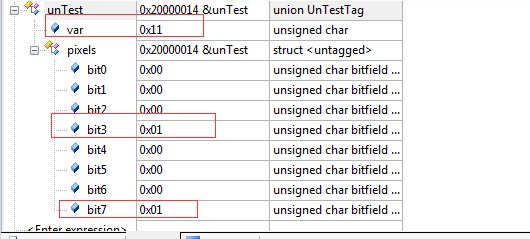
bit0 對應 MSB (第 7 位) = 0 ✗bit7 對應 LSB (第 0 位) = 1bit0..bit7 對應位元權重 2⁷..2⁰ (反轉)C 標準 (ISO/IEC 9899) 未規定 位元欄位在儲存單元內的分配順序。編譯器可自由選擇「從 LSB 向 MSB」或「從 MSB 向 LSB」分配。GCC/Clang 在小端目標上採用 LSB→MSB,大端目標上採用 MSB→LSB。
// 宏定義或 inline 函式,編譯器優化後零開銷
#define GET_BIT(val, n)  (((val) >> (n)) & 0x01)
#define SET_BIT(val, n)  ((val) |= (1 << (n)))
#define CLR_BIT(val, n)  ((val) &= ~(1 << (n)))

uint8_t val = 0x11;
bool b0 = GET_BIT(val, 0);  // 1
bool b4 = GET_BIT(val, 4);  // 1
// 於任何大小端架構下行為一致
文章提到的現象(左移方向在大小端不同)實際上是觀測角度差異:
0x11 (00010001) << 1 = 0x22 (00100010),位元向「高位權重」移動0x88 (10001000) << 1 = 0x10 (00010000) (溢出),位元同樣向「高位權重」移動結論:C 語言位移運算子定義於數值邏輯層面 (乘/除 2 的冪次),與記憶體位元組序無關。編譯器會自動生成正確指令。
Watch 視窗中變數值變化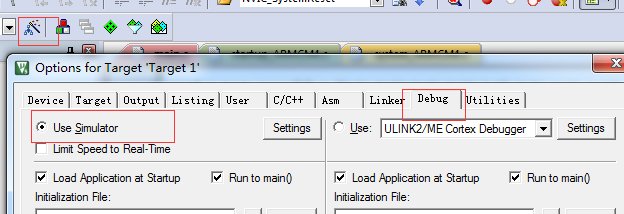
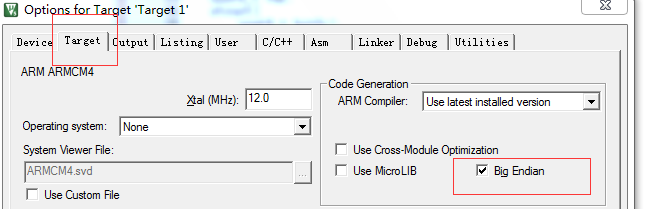
| 模式 | 風險等級 | 建議對策 |
|---|---|---|
| 陣列強轉結構體指標 | 🔴 極高 | 嚴禁用於跨平台程式碼;改用明確位元組組裝或序列化函式 |
| 聯合體位元欄位對應暫存器 | 🟠 高 | 僅限單一平台專案;跨平台請改用位元運算宏/函式 |
| 結構體 padding/alignment | 🟡 中 | 使用 ` |
| 位移運算 (<<, >>) | 🟢 無 | 可放心使用,語義由標準保證 |