垃圾回收 (GC) 是 Java 自動內存管理的核心支柱。理解 GC 算法原理、演進歷程及 HotSpot 具體實現,是排查內存問題、調優 JVM 參數、編寫高性能代碼的必修課。本文系統梳理 GC 觸發原因、四大基礎算法、分代收集策略、多線程 GC 模式,並配合內存結構圖解,構建完整知識體系。
代價:GC 線程消耗 CPU 時間,可能導致應用停頓 (Stop-The-World),需權衡吞吐量與延遲。
GC Roots (根集合):
判定邏輯:從 GC Roots 出發向下搜索,可達路徑上的對象為存活對象,不可達對象為垃圾。
| 算法 | 核心思想 | 優點 | 缺點 | 適用場景 |
|---|---|---|---|---|
| 標記-清除 (Mark-Sweep) | 1. 標記所有可回收對象 2. 統一清除 | 基礎算法,無需移動對象 | 1. 效率低(雙遍歷) 2. 產生大量不連續碎片 | 老年代、存活率高區域 |
| 複製 (Copying) | 內存劃分兩塊等大區域,每次用一塊,GC 時將存活對象複製到另一塊,清空已用區域 | 1. 實現簡單、無碎片 2. 分配指針碰撞,速度極快 | 內存利用率只有 50% | 新生代(存活率極低 ~2%) |
| 標記-整理 (Mark-Compact) | 標記後,將存活對象向一端移動,直接清理邊界外內存 | 1. 無碎片 2. 內存利用率高 | 需移動對象、更新引用,開銷大於複製 | 老年代、存活率高區域 |
| 標記-清除-整理 (CMS 混合模式) | 平時標記-清除,碎片超閾值時整理 | 平衡停頓與碎片 | 實現複雜 | 低延遲要求場景 |
標記-清除:
GC 前: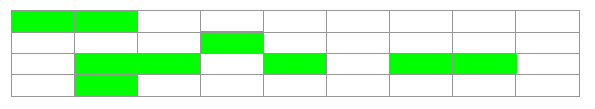
GC 後:
複製算法:
GC 前: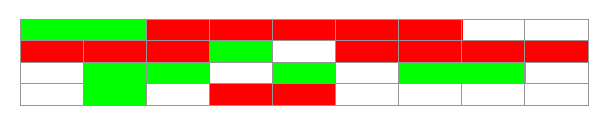
GC 後: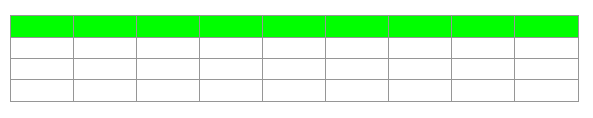
標記-整理:
GC 前:
GC 後:
綠色:存活對象 紅色:可回收對象 白色:未使用空間
代 特點 算法 典型收集器 新生代 對象朝生夕死,存活率低 (~2%) 複製算法 (8:1:1 Eden:S0:S1) Serial, ParNew, Parallel Scavenge 老年代 對象存活率高,無額外空間分配擔保 標記-清除 / 標記-整理 Serial Old, Parallel Old, CMS, G1, ZGC 對象生命週期流轉
- 新對象優先分配在 Eden
- Eden 滿觸發 Minor GC,存活對象 → S0
- 後續 Minor GC:Eden + S0 存活 → S1,清空 Eden+S0,角色互換
- 年齡計數器達閾值 (默認 15,CMS 6) → 晋升老年代
- 大對象 (字節數組/長字符串) 直接進老年代 (
PretenureSizeThreshold)- 動態年齡判斷:Survivor 同齡對象總大小 > Survivor 一半,直接晋升
五、漸進式 GC 技術:避免長時間 STW
1. 增量收集 / 火車算法
將老年代劃分固定大小「車廂」,每次處理一車廂。理論優雅但實現極其複雜,HotSpot 未採用。
2. 分代收集 —— 產業標準
不同代、不同時期、不同算法,將一次全堆 GC 拆解為多次局部 GC,大幅降低單次停頓。
六、多線程 GC 實現模式
| 模式 | 線程數 | STW | 優點 | 缺點 | 適用場景 |
|---|---|---|---|---|---|
| 串行 (Serial) | 1 | 是 | 無線程交互開銷,單核效率高 | 無法利用多核 | 單核、小堆 (<100MB)、Client 模式 |
| 並行 (Parallel) | 多 | 是 | 多核加速,吞吐量優先 | 停頓時間長,隨堆增大而增長 | 多核、批處理、科學計算、後台任務 |
| 並發 (Concurrent) | 多 | 極短/無 | 響應時間優先,用戶線程與 GC 線程並發 | CPU 開銷大、浮動垃圾、實現極其複雜 | Web 服務、GUI、電信交換、IDE |
關鍵區別:
本文提到了 Set 接口,下一筆記將深入探討 HashSet 實現原理,揭秘它如何「零代碼」複用 HashMap 實現去重語義。