XPath(XML Path Language)是一門在 XML 文檔中查找信息的語言,它允許開發者通過元素和屬性在 XML 文檔中進行導航。XPath 的返回值可以是節點、節點集合、文本,以及節點和文本的混合等。在 Java 開發中,結合 dom4j 库使用 XPath 可以極大地簡化 XML 解析工作。本文將詳細介紹如何在 Java 中使用 XPath 操作 XML,包含環境配置、核心 API 使用以及豐富的實戰範例。
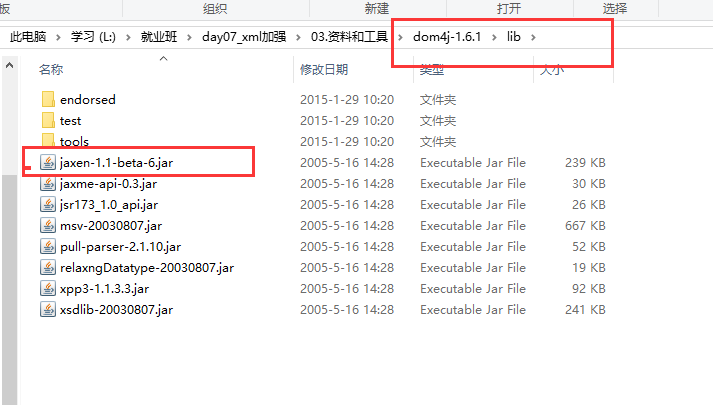
在開始編碼之前,首先需要導入必要的 JAR 包。dom4j 本身不包含 XPath 的實現,需要額外引入 jaxen-1.1-beta-6.jar。完整的依賴鏈如下:
導入後的項目結構示意圖:
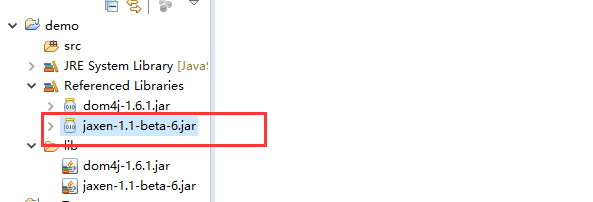
若不熟悉導包操作,可參考《Java 獲取 XML 節點總結之讀取 XML 文檔節點》一文。
dom4j 中使用 XPath 主要涉及兩個核心方法:
List<Node> selectNodes(String xpath):查詢多個節點對象,返回節點列表Node selectSingleNode(String xpath):查詢單個節點對象,返回唯一節點這兩個方法定義在 org.dom4j.Node 接口中,Document 和 Element 均實現了該接口,因此可以直接在文檔或元素上調用。
以下範例展示了各種常見 XPath 表達式的用法,代碼基於一個名為 contact.xml 的示例文件:
package com.vastsum.demo;

import java.io.File;
import java.io.FileOutputStream;
import java.util.List;

import org.dom4j.Document;
import org.dom4j.Element;
import org.dom4j.Node;
import org.dom4j.io.OutputFormat;
import org.dom4j.io.SAXReader;
import org.dom4j.io.XMLWriter;

/**
 * XPath selectNodes 使用示例
 * @author shutu008
 */
public class XPathDemo {

    public static void main(String[] args) throws Exception {
        // 1. 讀取 XML 文檔
        Document doc = new SAXReader().read(new File("./src/contact.xml"));
        String xpath = "";

        // ==================== XPath 語法分類演示 ====================

        /** 1. 絕對路徑 / : 從根節點開始匹配 */
        xpath = "/contactList";           // 匹配根元素
        xpath = "/contactList/contact";   // 匹配根下的 contact 子元素

        /** 2. 相對路徑 // : 文檔中任意位置匹配,不限層級 */
        xpath = "//contact/name";         // 所有 contact 下的 name
        xpath = "//name";                 // 文檔中所有 name 元素

        /** 3. 通配符 * : 匹配所有元素 */
        xpath = "/contactList/*";         // 根元素下所有直接子元素
        xpath = "/contactList//*";        // 根元素下所有後代元素(不限層級)

        /** 4. 謂語條件 [] : 篩選符合條件的節點 */
        xpath = "//contact[@id]";              // 帶有 id 屬性的 contact
        xpath = "//contact[2]";                // 第 2 個 contact(索引從 1 開始)
        xpath = "//contact[last()]";           // 最後一個 contact

        /** 5. 屬性選擇 @ : 選擇屬性節點 */
        xpath = "//@id";                       // 所有 id 屬性節點(返回 Attribute 對象)
        xpath = "//contact[not(@id)]";         // 不包含 id 屬性的 contact
        xpath = "//contact[@id='002']";        // id 為 002 的 contact
        xpath = "//contact[@id='001' and @name='eric']"; // 多條件組合

        /** 6. 文本內容 text() : 選擇元素的文本節點 */
        xpath = "//name/text()";               // 所有 name 元素的文本內容(返回 Text 對象)
        xpath = "//contact/name[text()='張三']"; // 文本為「張三」的 name 元素

        // ==================== 執行查詢並輸出結果 ====================
        List<Node> list = doc.selectNodes(xpath);
        for (Node node : list) {
            System.out.println(node);
        }

        // ==================== 可選:將修改後的文檔寫入文件 ====================
        FileOutputStream out = new FileOutputStream("d:/contact.xml");
        OutputFormat format = OutputFormat.createPrettyPrint();
        format.setEncoding("utf-8");
        XMLWriter writer = new XMLWriter(out, format);
        writer.write(doc);
        writer.close();
    }
}
selectSingleNode 適用於精確定位單一節點並進行修改操作:
package com.vastsum.demo;

import java.io.File;
import java.util.Iterator;

import org.dom4j.Attribute;
import org.dom4j.Document;
import org.dom4j.Element;
import org.dom4j.io.SAXReader;

/**
 * XPath selectSingleNode 使用示例
 * @author shutu008
 */
public class XPathDemo1 {
    public static void main(String[] args) throws Exception {
        // 1. 讀取 XML 獲取 Document 對象
        SAXReader saxReader = new SAXReader();
        Document doc = saxReader.read(new File("./src/contact.xml"));

        // 2. 使用 XPath 定位單個節點
        String xpath = "//contact[@id = '001']";
        Element contactElem = (Element) doc.selectSingleNode(xpath);

        // 3. 修改節點屬性
        contactElem.addAttribute("name", "001");

        // 4. 遍歷輸出該節點所有屬性
        for (Iterator it = contactElem.attributeIterator(); it.hasNext(); ) {
            Attribute conAttr = (Attribute) it.next();
            String conTxt = conAttr.getValue();
            String conAttrName = conAttr.getName();
            System.out.println(conAttrName + " = " + conTxt);
        }
    }
}
以上所有範例均基於以下 XML 文件進行操作:

<?xml version="1.0" encoding="UTF-8"?>
<contactList id="0">
  <contact id="001" class="style" name="lisi">
    <name>張三</name>
    <age>20</age>
    <phone>134222223333</phone>
    <email>zhangsan@qq.com</email>
    <qq>432221111</qq>
  </contact>
  <contact id="002">
    <name>李四</name>
    <age>20</age>
    <phone>134222225555</phone>
    <email>lisi@qq.com</email>
    <qq>432222222</qq>
  </contact>
  <contactTwo>
    <name>王五</name>
    <age>32</age>
    <phone>465431341</phone>
    <emali>af@qq.com</emali>
    <qq>46164694</qq>
  </contactTwo>
  <test>測試</test>
  <test>其他用途</test>
</contactList>
/ 比 // 效率更高,因為不需全文掃描。@id='value' 形式的謂語可大幅縮小搜索範圍。SAXReader 的特性設置或註冊命名空間上下文。DocumentException、IOException 等異常。掌握 XPath 配合 dom4j,能讓 Java 處理 XML 變得靈活高效,是企業級應用開發中的必備技能。