| 前綴 | 類型 | 長度 | 示例 | 含義 |
|---|---|---|---|---|
\u |
Unicode 轉義 | 固定 4 位十六進制(共 6 字符) | \u003B |
分號 ; (U+003B) |
\ + 八進制 |
八進制轉義 | 1-3 位八進制數字 | \12 |
換行符 LF (U+000A) |
\b \t \n \f \r \" \' \\ |
控制字符/字面量 | 固定 2 字符 | \n |
換行、制表、雙引號等 |
關鍵認知:Java 編譯器在詞法分析最早期(讀取源文件字符流時)就展開所有 \uXXXX,然後再進行語法分析。這導致兩個驚人後果:
public class Test {
    public static void main(String[] args) {
        // \u0073\u0079\u0073\u0074\u0065\u006D\u002E\u006F\u0075\u0074\u002E\u0070\u0072\u0069\u006E\u0074\u006C\u006E(\u0022Hello\u0022);
        // 上面一行展開後等同於:
        System.out.println("Hello");
    }
}
甚至可拆分關鍵字:
int \u0063 = 0; // 編譯後等同於 int c = 0;// \u000A System.out.println("This line is actually executed!");
// 上面的 \u000A 被展開為換行符,導致註釋提前結束,下面代碼生效!public class StringToUnicode {
public static String escape(String input) {
StringBuilder sb = new StringBuilder(input.length() * 6);
for (char c : input.toCharArray()) {
if (c <= 0x7F) { // ASCII 範圍可選擇不轉義
sb.append(c);
} else {
sb.append(String.format("\\u%04X", (int) c));
}
}
return sb.toString();
}
public static void main(String[] args) {
String code = "public class EggHello { public static void main(String[] args) { System.out.println(\"Hello,World\"); } }";
System.out.println(escape(code));
// 輸出:public class EggHello { public static void main(String[] args) { System.out.println(\"Hello,World\"); } }
// 非 ASCII 字符會變為 \uXXXX 形式
}
}| 場景 | 風險/用途 | 對策 |
|---|---|---|
| 源碼混淆/反編譯干擾 | 將關鍵邏輯寫為 Unicode 轉義,增加靜態分析難度 | 構建階段自動化轉義,配合 ProGuard 等混淆器 |
| 跨平台源碼分發 | 源文件編碼不一致(GBK/UTF-8)導致中文亂碼 | 統一源碼保存為 UTF-8,或全量轉義為 ASCII-only 文件 |
| 屬性文件 | .properties 規範要求 ISO-8859-1,非 ASCII 必須 \uXXXX |
使用 native2ascii 工具或 IDE 自動轉換 |
| 代碼注入攻擊 | 用戶輸入包含 \u000A 繞過單行註釋/字符串邊界 |
輸入驗證階段統一轉義/過濾反斜桿+u 模式 |
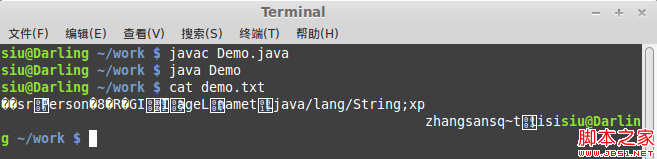
// 編譯
javac Test.java
// 反編譯查看常量池
javap -c -v Test.class | grep -A2 -B2 "Hello"
# 可見 CONSTANT_Utf8_info 表中已存儲解碼後的真實字符串,無 \uXXXX 痕跡Java Unicode 轉義(\uXXXX)是編譯器前端的純文本替換機制,在詞法分析階段展開,對後續語法樹、字節碼零影響。它既是解決跨編碼源碼分發的「通用閥」,也是繞過詞法結構的「隱形通道」。理解其展開時機與作用範圍,能避免「註釋失效、字符串截斷」等詭異 Bug,亦可在源碼保護、屬性文件國際化等場景精準應用。