在探討陣列指標時,必須同時考量類型與維度這兩個屬性。換句話說,一個陣列若排除其中儲存的數值,其種類可由類型與維度來唯一表示。
在 C 與 C++ 中,陣列指標即為陣列的起始位址(亦即第一個元素的位址),標準文件規定陣列名代表陣列位址(這是位址數值層面的陣列表示)。例如:
int a[10];
int *p;
p = &a[0]; // 與 p = a 等價
因為 a 是陣列名,代表該陣列位址;同時第一個元素為 a[0],故 &a[0] 也代表該陣列位址。但在高維陣列時,必須考量維度帶來的影響。
a[10] 是一個包含 10 個 int 的陣列類型,a 並非一般指標變數(雖然 C++ 允許 int[] 隱式轉換為 int*)。a 代表陣列首位址,數值上與 &a[0] 相同,故可用指標變數或 a 操作陣列。
需注意:
p[i] 與 a[i] 均代表第 i+1 個元素;p+i 與 a+i 代表第 i+1 個元素位址,故可用 *(p+i) 與 *(a+i) 存取;p+1 非指標數值加一,而是跳過目前指向類型的長度(Win32 下 int 為 4 bytes)。以二維陣列 a[4][6] 為例,陣列名代表起始位址,故 a(第一層)與 &a[0][0] 數值相同但意義不同。可理解為:a 為一維陣列(第一層),含四個元素 a[0]~a[3](第二層),每個元素又含六個元素(第三層),存取過程為 a → a[0] → a[0][0]。
整體而言:a 為 4 行 6 列二維陣列,a 指向陣列首位址(&a[0]),a[0] 指向一行,為該行名字(與該行首元素位址 &a[0][0] 相同)。數值上 a、a[0]、&a[0][0] 相同,但層次不同。
a+i 表示第 i+1 個元素 *(a+i) 的位址,而 *(a+i) 指向一個陣列,*(a+i)+j 為該陣列第 j+1 個元素位址,故存取元素可用 *(*(a+i)+j)(即 a[i][j])。
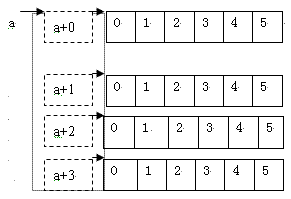
對照圖示,對於 a[4][6],下列敘述均正確:
a 為陣列類型,*a 指向一個陣列;a+i 指向一個陣列;a、*a、&a[0][0] 數值相同;a[i]+j 與 *(a+i)+j 同一概念。總結:對二維指標 a,它指向陣列 a[0,1,2,3],用 * 可降級到第二層,使 *a 指向第一個真正陣列。其他維度與類型同理。
可宣告指標變數指向一個陣列,例如:
int (*p)[5];
此時 p 為指標,指向含 5 個 int 元素的陣列,指向其他會出錯。初始化可用 *a、*(a+1)、a[2] 等,因二維陣列中只有這些表達式具有相互類似的意義。
指標陣列指陣列中每個元素皆為指標,例如:
int *p[10]; // 而非 int (*p)[10]
char *p[10];
此時 p 為指標(數值上與 &p[0] 相同)。若有 int t[10],用 int *pt = t 指向 t;若為 int *t[10],需用指標的指標:
int **pt = t;
因 int *t[10] 中每個元素為指標,t 指向該陣列(數值上等同 &t[0]),即指向一個指標變數,故需用 int **pt。
指標變數內部儲存另一物件位址,故可指向一般變數;指標變數本身也有位址,故可有東西指向該指標變數,再透過它指向物件。定義指標的指標(二重指標):
int *p1 = &i;
int **p2 = &p1;
常見匹配(亦為易錯處):
int a[3], b[2][3], c, *d[3];
void fun1(int *p);
void fun2(int (*p)[3]);
void fun3(int **p);
void fun4(int p[3]);
void fun5(int p[]);
void fun6(int p[2][3]);
void fun7(int (&p)[3]);
編譯時不產生錯誤的搭配(邏輯上不一定正確):
fun1、fun4、fun5:a, &a[i], *b, b[i], &b[i][j], &c, d[i]fun2:b, b+ifun3:dfun6:bfun7:a原因分析:
fun1、fun4、fun5:編譯器忽略陣列大小,視為指標,形式相同;fun7:引用需考慮陣列大小,必須與宣告完全一致;fun2:p 為指向含 3 元素陣列的指標,b、b+i 符合;fun3:p 為指標的指標,d 指向 d[0](指標),故 d 為指標的指標;fun6:p 為 2×3 陣列類型,與 b 完全匹配。C++ 規定函數位址即函數名。函數指標需表達函數的參數列表與返回類型,以滿足解析唯一性。例如:
int (*p)(int i, int j); // 正確
int *p(int i, int j);   // 錯誤:變成返回指標的函數宣告
C++ 為安全考量,指標與指向物件類型須一致。指向 int min(int, int) 可行,指向 int min(double, double) 則不可。函數指標同樣怕發生「懸空」,使用前需判斷有效性或定義時初始化:
int (*p)(int, int) = min;
int (*p)(int, int) = &min;
int (*p)(int, int) = 0;
函數指標可作函數參數。例如積分演算法,對不同數學函數積分(假設皆為一元):
template <class T>
T integrate(T lower, T upper, T (*)(T) = 0) throw(integrated_exp);
最後參數為函數指標,預設值 0。若有 double line(double x) { return a*x+b; },即可使用。函數指標也可作返回類型(注意非函數本身):
typedef int (*PF)(int);
PF getProcessMethod(); // 正確
返回指標的函數需小心兩大問題:
UserType *Process() {
    UserType ut(param-list);
    return &ut; // 錯誤!
}
UserType *Process() {
    UserType *put = new UserType(param-list);
    return put; // 呼叫端若不 delete 會洩漏
}
故多數程式設計師改用指標或參考參數來替代此類返回。
類成員與一般變數差異在於所在域(scope),決定使用範圍。指標指向類成員函數或變數時,除表達返回類型、參數列表或類型外,還需說明所指成員的域,使用類域限定:
class NJUPT {
    static double money = 20000000;
    int num;
public:
    NJUPT(): num(10) {}
    int get() { return num; }
    double getMoney() { return money; }
};

int NJUPT::*p;           // 指向 int 型成員變數
int (NJUPT::*p)();       // 指向 int f() 型成員函數
使用需該類型的變數或指標:
NJUPT s, *ps;
cout << s.*p;
cout << (s->*p)();
靜態成員則可像一般外部變數/函數一樣定義指標:
double *p = &NJUPT::money;
double (*p)() = &NJUPT::getMoney;