面對日漸增長的用戶推薦數據,單純使用 POI 或逐條 JDBC 插入早已力不從心。本文示範如何利用 Spring Batch 的 Chunk-oriented 處理模型,結合 FlatFileItemReader、ItemProcessor 與 JdbcBatchItemWriter,實現從管道符分隔的文本文件讀取、數據清洗驗證,到批量入庫/更新的完整流程。
數據分析團隊每日產出包含 uid、tag、type 的文本文件,需完成:
考慮到數據量大、需高吞吐,選用 Spring Batch 而非 POI,並採用 MyBatis + Druid 連接池作為持久層支撐。
<dependencies>
    <dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-batch</artifactId></dependency>
    <dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-data-jpa</artifactId></dependency>
    <dependency><groupId>org.mybatis.spring.boot</groupId><artifactId>mybatis-spring-boot-starter</artifactId><version>1.2.0</version></dependency>
    <dependency><groupId>mysql</groupId><artifactId>mysql-connector-java</artifactId><scope>runtime</scope></dependency>
    <dependency><groupId>com.alibaba</groupId><artifactId>druid</artifactId><version>1.0.26</version></dependency>
    <dependency><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId><version>1.12.6</version></dependency>
    <dependency><groupId>org.apache.commons</groupId><artifactId>commons-lang3</artifactId><version>3.4</version></dependency>
</dependencies>@Data @EqualsAndHashCode @NoArgsConstructor @AllArgsConstructor
public class UserMap extends BaseModel {
@Column(name = "uid", unique = true, nullable = false) private Long uid;
@Column(name = "tag") private String tag;
@Column(name = "type") private Integer type;
}@Configuration @EnableBatchProcessing
public class BatchConfiguration {
@Autowired private JobBuilderFactory jobBuilderFactory;
@Autowired private StepBuilderFactory stepBuilderFactory;
@Autowired @Qualifier("prodDataSource") DataSource prodDataSource;
// 1. 讀取器:管道符分隔,映射到 UserMap
@Bean
public FlatFileItemReader<UserMap> reader() {
FlatFileItemReader<UserMap> reader = new FlatFileItemReader<>();
reader.setResource(new ClassPathResource("c152.txt"));
reader.setLineMapper(new DefaultLineMapper<UserMap>() {{
setLineTokenizer(new DelimitedLineTokenizer("|") {{
setNames(new String[]{"uid", "tag", "type"});
}});
setFieldSetMapper(new BeanWrapperFieldSetMapper<UserMap>() {{
setTargetType(UserMap.class);
}});
}});
return reader;
}
// 2. 新增寫入器
@Bean
public JdbcBatchItemWriter<UserMap> importWriter() {
JdbcBatchItemWriter<UserMap> w = new JdbcBatchItemWriter<>();
w.setItemSqlParameterSourceProvider(new BeanPropertyItemSqlParameterSourceProvider<>());
w.setSql("INSERT INTO user_map (uid,tag,type) VALUES (:uid, :tag, :type)");
w.setDataSource(prodDataSource);
return w;
}
// 3. 更新寫入器
@Bean
public JdbcBatchItemWriter<UserMap> updateWriter() {
JdbcBatchItemWriter<UserMap> w = new JdbcBatchItemWriter<>();
w.setItemSqlParameterSourceProvider(new BeanPropertyItemSqlParameterSourceProvider<>());
w.setSql("UPDATE user_map SET type = :type, tag = :tag WHERE uid = :uid");
w.setDataSource(prodDataSource);
return w;
}
// 4. 處理器:根據狀態決定新增/更新邏輯
@Bean
public UserMapItemProcessor processor(UserMapItemProcessor.ProcessStatus status) {
return new UserMapItemProcessor(status);
}
// 5. Job & Step 組裝
@Bean public Job importUserJob(JobCompletionNotificationListener listener) { ... }
@Bean public Step importStep() { return stepBuilderFactory.get("importStep")
.<UserMap, UserMap>chunk(100).reader(reader()).processor(processor(IMPORT)).writer(importWriter()).build(); }
@Bean public Job updateUserJob(JobCompletionNotificationListener listener) { ... }
@Bean public Step updateStep() { return stepBuilderFactory.get("updateStep")
.<UserMap, UserMap>chunk(100).reader(reader()).processor(processor(UPDATE)).writer(updateWriter()).build(); }
}public class UserMapItemProcessor implements ItemProcessor<UserMap, UserMap> {
private static final int MAX_TAG_LENGTH = 200;
private static final Pattern TAG_PATTERN = Pattern.compile("^[a-zA-Z0-9\\u4E00-\\u9FA5_-]+$");
private final ProcessStatus processStatus;
@Autowired private IUserMapService userMapService;
public UserMapItemProcessor(ProcessStatus status) { this.processStatus = status; }
@Override
public UserMap process(UserMap item) throws Exception {
String cleanTag = cleanTag(item.getTag());
Integer type = item.getType() != null ? item.getType() : 0;
if (StringUtils.isBlank(cleanTag)) return null;
UserMap exist = userMapService.selectOne(Map.of("uid", item.getUid()));
if (exist == null) {
return (processStatus == IMPORT) ? new UserMap(item.getUid(), cleanTag, type) : null;
} else {
if (processStatus == UPDATE && !cleanTag.equals(exist.getTag()) || !type.equals(exist.getType())) {
exist.setTag(cleanTag); exist.setType(type);
return exist;
}
}
return null;
}
private static String cleanTag(String raw) {
if (StringUtils.isBlank(raw)) return null;
try {
// 原始格式:Counter({'標籤1': 3, '標籤2': 2, ...})
String inner = raw.substring(raw.indexOf("{")+1, raw.lastIndexOf("}"));
return Arrays.stream(inner.split(","))
.map(s -> s.split(":")[0].replaceAll("['\\s]", ""))
.filter(TAG_PATTERN.asPredicate())
.reduce((a, b) -> a + "," + b)
.map(s -> s.length() > MAX_TAG_LENGTH ? s.substring(0, MAX_TAG_LENGTH) : s)
.orElse(null);
} catch (Exception e) { log.error("Tag clean failed", e); return null; }
}
enum ProcessStatus { IMPORT, UPDATE }
}清洗邏輯利用 Java 8 Stream API 並行處理,正則過濾非法字符,最終以逗號拼接並截斷至 200 字符。
@Component
public class JobCompletionNotificationListener extends JobExecutionListenerSupport {
    private final JdbcTemplate jdbcTemplate;
    @Autowired public JobCompletionNotificationListener(JdbcTemplate jdbcTemplate) { this.jdbcTemplate = jdbcTemplate; }
    @Override public void afterJob(JobExecution jobExecution) { System.out.println("Batch job finished."); }
}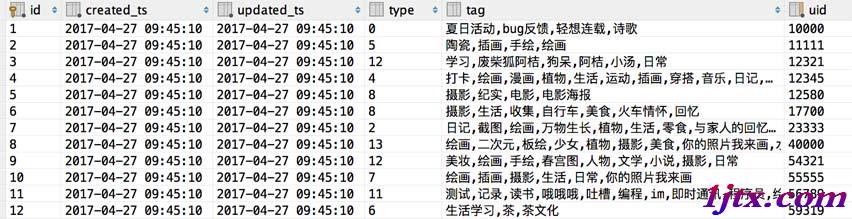
啟動專案後,Spring Batch 會自動執行配置的 Job,將文本數據高效導入數據庫,控制台輸出「end .....」表示完成。
Spring Batch 的 Chunk 模式(讀-處理-寫)配合批量 SQL,極大提升大數據量導入效能。本文展示的「讀取→清洗→分流新增/更新」模式,可直接套用至日誌分析、數據遷移等場景。