身為開發人員,我們總是對程式碼的效能念茲在茲。但當我深入探討效能主題時,經常收到這類郵件:「我的測試程式顯示動態編譯比靜態編譯快,這跟你上一篇文章的觀點完全相反!」附帶的所謂「基準測試」程式碼,往往暴露出作者對 JVM 執行位元組碼機制缺乏基本認知。在剖析那些寫得糟糕的微基準測試之前,我們必須先理解 JVM 幕後的動態編譯與優化機制——這正是分辨優劣微基準測試的關鍵(不幸的是,好的微基準測試鳳毛麟角)。
Java 應用程式的編譯流程與 C、C++ 等靜態編譯語言截然不同。靜態編譯器直接將原始碼轉換為目標平台的機器碼,不同硬體需要不同編譯器。Java 編譯器 javac 則將原始碼編譯為可攜式的 JVM 位元組碼——即 JVM 的「虛擬機器指令」。與靜態編譯器不同,javac 几乎不做任何優化;在靜態語言中由編譯器完成的優化工作,在 Java 中是在程式執行時期由執行環境動態進行。
早期的 JVM 完全採用解釋器模式:逐條解釋位元組碼,而非編譯成機器碼直接執行。這項技術雖然驗證了概念可行性,但效能低落,因為系統花在執行解釋器上的時間,比執行實際程式還要多,導致 Java 早期獲得「太慢」的惡名。
為改善效能,下一代 JVM 引入即時 (JIT) 編譯器。嚴格定義上,基於 JIT 的虛擬機會在執行前將所有位元組碼轉換為機器碼,但採用惰性方式:只有確定某條程式碼路徑即將執行時,才會編譯該路徑(因此得名「即時編譯」)。這使程式啟動更快,避免了冗長的啟動編譯階段。
然而 JIT 有其缺陷:為避免嚴重啟動延遲,JIT 編譯器必須極快,因此無法投入大量時間做優化。早期 JIT 編譯器在內聯假設方面較為保守,因為它們無法預知後續會載入哪些類別。此外,JIT 一詞常被廣義使用,泛指任何將位元組碼動態轉換為機器碼的過程——即使包含解釋執行的過程也在內。
HotSpot 採用混合策略:先以解釋器模式執行,收集效能分析資料,僅編譯「熱門」程式碼——即執行最頻繁的程式碼路徑。這帶來多項優勢:
HotSpot 提供兩種編譯器:Client 編譯器(預設)針對啟動時間與記憶體占用優化,編譯速度快但優化程度較低;Server 編譯器(-server 參數啟用)針對長期運行的伺服器應用優化,追求最大峰值運算速度,優化更激進但編譯耗時較長。Server 編譯器能執行多種標準優化(代碼提升、公共子運算式消除、迴路展開、範圍檢查消除、死碼消除、資料流分析),以及靜態編譯語言難以實現的優化(如虛擬方法呼叫的多態內聯)。
HotSpot 的編譯非「全有或全無」。解釋執行一定次數後會重新編譯成機器碼,JVM 會持續分析,若發現程式碼路徑極熱或有進一步優化空間,會以更高優化層級重新編譯。同一段位元組碼在應用程式生命週期中可能被重新編譯多次。使用 -XX:+PrintCompilation 參數可觀察編譯器活動。
早期 HotSpot 每次編譯一個方法。當方法累計執行次數超過閾值(早期版本為 10,000 次後向分支)被判定為熱門方法,但編譯完成後,當前執行的方法呼叫不會切換到編譯版本,需退出並重新進入方法,後續呼叫才使用編譯碼。這導致計算密集型程式(所有計算在單次方法呼叫中完成)可能永遠用不到編譯版本。
新版 HotSpot 引入棧上替換 (On-Stack Replacement, OSR),支援在迴圈執行中途從解釋執行切換到編譯碼,或在不同編譯版本間切換,解決了上述問題。
傳統判斷方法 A 是否比 B 快的方式是編寫微基準測試。這在 C 語言中相對可靠:甚至不用執行程式,只需檢視編譯輸出的機器碼即可推斷效能特徵。編譯器生成的指令即將執行的機器碼,其時間特徵相對可預測。若編譯器優化掉了無用程式碼,機器碼中直接可見——程式碼不見了。
但 HotSpot JIT 在執行時持續重新編譯 Java 位元組碼,重新編譯觸發時機難以預測(基於分析資料累積、新類別載入、未執行路徑的類別已載入等)。持續重新編譯下的時間測量極其混亂,通常必須讓 Java 程式運行極長時間(甚至數小時或數天)才能獲得有意義的資料。
優化編譯器擅長找出死碼——對程式輸出無影響的程式碼。但基準測試通常不產生輸出,導致部分或全部程式碼可能被悄無聲息地優化掉,實際測量的執行量遠低於預期。具體而言,許多微基準測試在 -server 模式下比 -client 快得多,並非因為 Server 編譯器更快,而是它更擅長優化掉死碼。不幸的是,能讓基準測試極快(甚至完全被優化掉)的死碼優化,在處理實際工作程式碼時效果未必理想。
以下測試程式碼表面上測試多執行緒調度開銷,實則測量的並非預期目標:
public class StupidThreadTest {
    public static void doSomeStuff() {
        double uselessSum = 0;
        for (int i = 0; i < 1000; i++) {
            for (int j = 0; j < 1000; j++) {
                uselessSum += (double) i + (double) j;
            }
        }
    }
    public static void main(String[] args) throws InterruptedException {
        doSomeStuff(); // 預熱嘗試
        int nThreads = Integer.parseInt(args[0]);
        Thread[] threads = new Thread[nThreads];
        for (int i = 0; i < nThreads; i++)
            threads[i] = new Thread(new Runnable() {
                public void run() { doSomeStuff(); }
            });
        long start = System.currentTimeMillis();
        for (int i = 0; i < threads.length; i++) threads[i].start();
        for (int i = 0; i < threads.length; i++) threads[i].join();
        long end = System.currentTimeMillis();
        System.out.println("Time: " + (end - start) + "ms");
    }
}
因為 uselessSum 從未被使用,編譯器判定 doSomeStuff 全部為死碼並全部優化掉。迴圈消失,只剩空方法。執行結果顯示 Server JVM 比 Client JVM 快 40 倍,實際上只是 Server 編譯器更徹底地移除了死碼——這不能作為 Server JVM 效能優異的證據。
測量效能時,我們想知道的是編譯後的效能,而非解釋執行效能。因此需要「預熱」JVM——讓目標操作執行足夠長,使編譯器在計時前完成編譯並替換解釋碼。早期 JIT 有簡單公式:多次呼叫、啟動計時、再執行若干次。若預熱超過編譯閾值,計時調用皆為編譯碼執行。
但現代動態編譯器讓事情複雜化:編譯器運行次數難以預測,JVM 自行決定何時從解釋切換到編譯,同一程式碼路徑可能編譯、重新編譯多次。若不處理這些事件的計時問題,會嚴重扭曲結果。圖 1 展示了動態編譯導致的計時扭曲:編譯發生時間不同,測量到的「效能」差異極大。
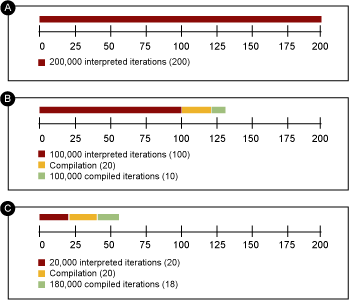
到底多少預熱才夠?沒人知道。最好的做法是用 -XX:+PrintCompilation 運行基準測試,觀察編譯觸發點,調整程式結構確保編譯在計時前完成、計時期間不再發生編譯。
為了預熱,測試程式碼需多運行幾次,但這會觸發垃圾收集(GC),同樣會嚴重扭曲計時。使用 -verbose:gc 觀察 GC 耗時並調整資料,或長時間運行觸發多次 GC 以攤銷成本。
許多標準優化僅能在「基本區塊」內進行,因此內聯方法呼叫對優化至關重要。內聯不僅消除呼叫開銷,還給優化器提供更大優化區塊,帶來顯著死碼優化機會。但虛擬方法對內聯構成障礙——Java 中虛擬函數呼叫比 C++ 普遍得多。
動態編譯器利用全域資訊做更好決策:假設尚未載入的類別擴展了 Foo,編譯器可將虛擬呼叫轉為直接呼叫(單態呼叫轉換)並內聯。但類別可動態載入:若載入了擴展 Foo 的新類別,基於舊假設的優化碼即失效。JVM 能偵測此情況,取消生成碼並退回解釋或重新編譯。編譯器主動做內聯決策以獲高效能,假設失效時再收回——這優化如此有效,以致給未被覆寫的方法加 final 關鍵字對實際效能提升已微乎其微。
public class StupidMathTest {
    public interface Operator { public double operate(double d); }
    public static class SimpleAdder implements Operator { public double operate(double d) { return d + 1.0; } }
    public static class DoubleAdder implements Operator { public double operate(double d) { return d + 0.5 + 0.5; } }
    public static class RoundaboutAdder implements Operator { public double operate(double d) { return d + 2.0 - 1.0; } }
    public static void runABunch(Operator op) {
        long start = System.currentTimeMillis();
        double d = 0.0;
        for (int i = 0; i < 5000000; i++) d = op.operate(d);
        long end = System.currentTimeMillis();
        System.out.println("Time: " + (end - start) + " ignore:" + d);
    }
    public static void main(String[] args) {
        Operator ra = new RoundaboutAdder();
        runABunch(ra); // 失敗的預熱嘗試
        runABunch(ra);
        Operator sa = new SimpleAdder();
        Operator da = new DoubleAdder();
        runABunch(sa);
        runABunch(da);
    }
}
結果顯示:RoundaboutAdder (14ms) 最快,DoubleAdder (76ms) 次之,SimpleAdder (88ms) 最慢。這不可能是算術差異導致。實際發生的是:預熱後 RoundaboutAdder 和 runABunch 被編譯,對 Operator 和 RoundaboutAdder 進行單態呼叫轉換,首輪極快。第二輪 (SimpleAdder) 觸發反優化,退回虛擬分派並重新編譯,較慢。第三輪 (DoubleAdder) 重新編譯較少,較快。先執行的實作總是最快——這個基準測試除說明「動態編譯語言基準測試比想像中微妙」外,無任何結論價值。
這些例子錯誤明顯,容易發現問題。但更微小的扭曲也能誤導效能測試,卻不觸發警覺。本文列舉的只是微基準測試扭曲的常見來源,還有更多。核心觀念是:你測量的通常不是你以為在測量的。對於無實際負載、執行時間不夠長的效能測試結果,務必保持高度懷疑。