當併發用戶數顯著增長,單台機器的效能往往無法滿足需求,或是受限於單一 JVM 實例的 GC 機制,導致應用難以進一步擴展。此時,將系統部署到多個 JVM 實例甚至多台伺服器上運行,即為水平擴展。值得注意的是,即便在同一台物理機器上運行多個 JVM 實例,也屬於水平擴展範疇,而非垂直擴展。因為 JVM 之間無法透過管道、共享記憶體或訊號量通訊,最高效的方式是 Socket 通訊。換言之,若應用能跨多個 JVM 運行,通常也能平滑擴展至多台伺服器。
隨著廉價高效能伺服器普及,透過叢集組裝低成本機器群,可獲得超越昂貴超級電腦的運算能力。但這也帶來了管理複雜度與程式模型的挑戰,如節點間吞吐量與延遲問題。Java EE 叢集技術已相當成熟,內部機制可參考 TSS 上的《Uncover the Hood of J2EE Clustering》。
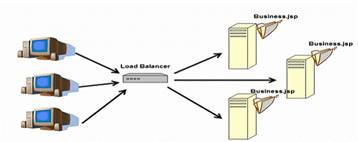
最具擴展性的架構莫過於無共享叢集架構。在此架構中,每個節點功能完全相同,且無需感知其他節點存在。負載平衡器負責將請求分發至後端實例,僅執行請求分派、健康檢查、Session 保持等輕量工作,極少成為瓶頸。若後端資料庫系統足夠強大,單純增加節點即可實現運算能力的線性增長。
幾乎所有 Java EE 廠商皆實作 HttpSession Failover,確保節點故障時 Session 不遺失。但這實質上打破了無共享原則:相同 Session 資料需在兩個以上節點間共享。除非萬不得已,建議避免使用 Session Failover。因為故障發生時,Failover 並無法完全避免錯誤,反而會損害效能與擴展性。
若為了用戶體驗必須啟用 Failover,關鍵在於選擇可擴展的複寫方案。廠商提供的方案包括:資料庫持久化、中央狀態伺服器、節點間記憶體複寫。其中成對節點複寫(Paired Node Replication)最具擴展性,為 BEA WebLogic、JBoss、IBM WebSphere、GlassFish V2+ 所採用。最不推薦資料庫持久化 Session:實驗室測試顯示,若 Session 物件頻繁更新,僅 3-4 個節點即可導致資料庫崩潰。
Java EE(特別是 EJB)天生為分散式運算設計,解耦業務邏輯與遠端元件讓多層架構流行。但對擴展性而言,減少分散式層次反而更有利。
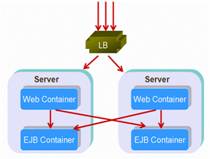
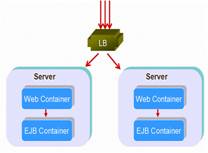
實驗室以政府專案測試同樣伺服器數量下的兩種部署:分散式與 Collocated。結果證明 Collocated 部署擴展性更佳。假設一個方法調用多個 EJB,若每次調用都經負載平衡分散到不同伺服器,會產生大量無謂的跨伺服器呼叫,甚至導致應用崩潰;若涉及跨伺服器交易,效能損害更大。Collocated 方式將相關元件部署在同一 JVM,避免遠端呼叫開銷。
叢集系統擴展後的效能,取決於對不支援線性擴展的共享資源的操作:資料庫伺服器、JNDI 樹、LDAP 伺服器、外部檔案系統等。
幾乎所有 Java EE 專案都使用物件快取提升效能,但許多快取僅設計給單 JVM 環境。叢集中每個 JVM 維護自己的快取,為保持狀態一致需同步,同步機制有時比不使用快取效能更差。因此可擴展的分散式快取系統至關重要。
測試結果:Terracotta 能良好擴展至 10 節點,5 節點內效能極高;Memcached 則在 20+ 節點時表現優異。
Memcached 透過兩階段 Hash 實現鍵值查找:客戶端先依伺服器列表 Hash 定位伺服器,伺服器端再做內部 Hash 定位資料。客戶端 Hash 層使得新增節點極簡單,無節點互連負載、無多播協議洪水效應。雖非 Java 產品,但提供 Java Client API,整合輕鬆。
使用關鍵注意事項:
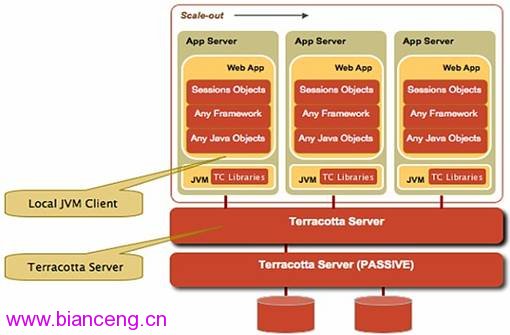
Terracotta 為企業級開源 JVM 級叢集方案,擴展 JVM 記憶體模型,讓不同虛擬機上的執行緒如同在同一 JVM 中交互。程式設計方式與單機應用無異,無專屬 API,透過位元碼織入(Bytecode Weaving) 注入叢集邏輯。實驗室測試顯示超過 20 節點時擴展性不佳,推測與其互連或多播協議機制有關(僅代表實驗室測試結果)。
單執行緒任務是擴展性瓶頸。對於處理巨大資料集的任務(如每週 120GB 日誌分析),單執行緒需 4 小時,採用 Hadoop MapReduce 水平擴展至 10+ 節點並行,僅需 7 分鐘。
MapReduce 由 Google 提出,包含 Map(並行處理資料集產生中間結果)與 Reduce(合併中間結果)兩階段。Hadoop 為開源純 Java 實作,支援大型廉價叢集,廣泛應用於 Yahoo、Amazon EC2/S3、Sun Grid Engine。應用場景涵蓋分散式檢索、排序、Web 鏈結分析、日誌分析、索引重建、文件叢集、機器學習、統計機器翻譯等。
MPI(Message Passing Interface)為語言無關的平行通訊協定,Java 實作有 mpiJava(JNI 綁定 Native MPI)與 MPJ(100% 純 Java)。CCJ 提供 barrier、broadcast、scatter、gather 等集合操作,底層用 Java RMI,支援複雜序列化物件傳遞。
Google 為滿足擴展需求,自研 GFS(分散式檔案系統)與 Bigtable(分散式資料庫),不遵循 POSIX 或 ANSI SQL 標準,卻完美支撐其海量儲存與擴展需求。
實驗室測試某社交網站應用(Tomcat + MySQL,20+ 廉價 PC Server),採用用戶資料分區:不同用戶資料存放於不同資料庫實例,元資訊表記錄路由規則。應用先查元資訊表定位目標資料庫,再執行操作。
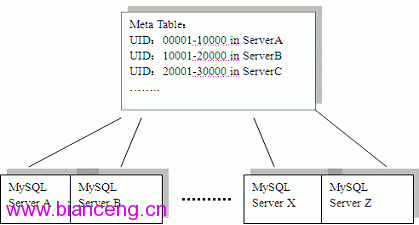
優勢:擴展寫入頻寬(並行寫入)、高可用性(單庫故障僅影響部分用戶)。挑戰:動態增減節點難用連線池、兩步操作難用 ORM、跨庫複雜查詢困難。架構師表示已準備好應對方案,甚至預留了元資訊表再分區的二級路由機制。