承接上篇理論基礎,本文詳細剖析 Snap-ConnectionPool 的核心架構設計,展示其如何透過物件導向封裝實現透明化、高效率的資料庫資源管理。
在標準 JDBC 中,應用程式直接使用 Driver 介面操作資料庫。Snap-ConnectionPool 在應用與 JDBC Driver 之間引入連線池層,內部實作三種邏輯資源物件,分別對應 JDBC 的三大核心介面:
PooledConnection → 封裝 java.sql.ConnectionPooledStatement → 封裝 java.sql.StatementPooledResultSet → 封裝 java.sql.ResultSet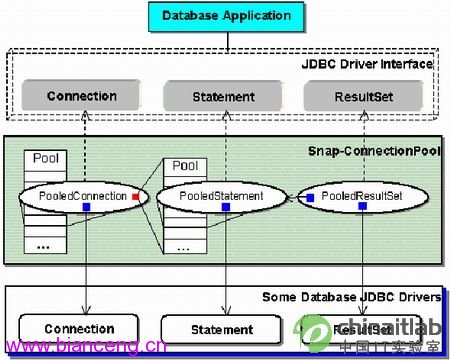
這三類物件繼承了 JDBC 原有的「爺-父-子」從屬關係,形成連鎖管理體系,具備四大特性:
ConnectionManager 為單例管理器,統管多個具名連線池(ConnectionPool),各池對應不同資料庫實例。透過配置檔集中管理原本散落各處的資料庫連線參數(JDBC URL、帳號、密碼等),簡化維運。
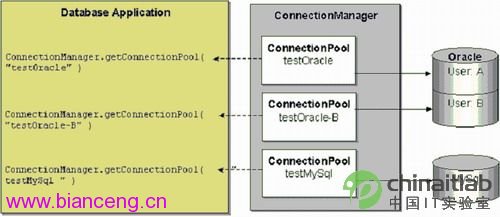
原本標準 JDBC 寫法:
DriverManager.registerDriver(new oracle.jdbc.driver.OracleDriver());
Connection conn = DriverManager.getConnection(url, user, pass);
Statement st = conn.createStatement();
ResultSet rs = st.executeQuery("select * from demo_table");
// ... 資料操作
rs.close(); st.close(); conn.close();
改用 Snap-ConnectionPool 後,僅需變更連線取得方式:
import java.sql.*;
import net.snapbug.util.dbtool.*;

ConnectionPool dbConn = ConnectionManager.getConnectionPool("testOracle");
Statement st = dbConn.createStatement();
ResultSet rs = st.executeQuery("select * from demo_table");
// ... 資料操作
rs.close(); st.close(); // 連線自動歸還池中,無需 close()
若應用遺漏 rs.close() 或 st.close(),連線池的超時機制會自動回收資源,避免洩漏。
唯有具備上述功能,應用程式才能專注於業務邏輯開發,不再受困於資料庫連線管理的複雜性與不穩定風險。