使用者輸入關鍵字時常因拼寫錯誤導致搜尋無結果,造成流失。Google 的「您是不是要找」功能能根據編輯距離推薦相近詞彙。本文展示如何利用 Apache Lucene SpellChecker 快速整合此功能。
Lucene SpellChecker 採策略模式封裝上述算法,預設 Levenshtein,精度閾值 0.5(可調 0~1)。
lucene-core-3.0.0.jar
lucene-spellchecker-3.0.0.jar// 1. 建立索引目錄
Directory dir = new RAMDirectory(); // 或 FSDirectory
// 2. 實例化 SpellChecker
SpellChecker sp = new SpellChecker(dir);
// 3. 載入詞典(每行一詞)
sp.indexDictionary(new PlainTextDictionary(new File("dictionary.txt")));
// 4. 查詢建議
String query = "Arnold Swuazeneger";
String[] suggestions = sp.suggestSimilar(query, 5); // 取前 5 筆
System.out.println("Your Term: " + query);
for (String w : suggestions) System.out.println("Did you mean: " + w);Seth MacFarlane
Arnold Schwarzenegger
Scarlett Johansson
Rodrigo Santoro
java
lava
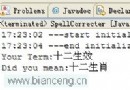
bulletYour Term: arnold swuazeneger
Did you mean: Arnold Schwarzenegger
Your Term: bava
Did you mean: java
Did you mean: lava
Did you mean: bullet| 測試 | 詞典量 | 精度 | 算法 | 索引時間(ms) | 查詢時間(ms) |
|---|---|---|---|---|---|
| T1 | 5 | 0.5 | Levenshtein | 73 | 25 |
| T2 | 81,000 | 0.5 | Levenshtein | 3402 | 28 |
| T3 | 81,000 | 0.5 | JaroWinkler | 3356 | 26 |
| T4 | 81,000 | 0.5 | NGram | 3354 | 27 |
| T5 | 81,000 | 0.9 | Levenshtein | 3325 | 27 |
| T6 | 81,000 | 0.3 | Levenshtein | 3408 | 25 |
核心難點不在算法,而在於建立「領域專屬詞典」:電子商務需包含所有商品名、品牌、同義詞;定期從搜尋日誌挖掘高頻錯拼詞補充詞典,才能真正提升轉換率。