在 JavaEye 瀏覽技術博客時,發現 NeuronR 分享了編譯器實踐的經驗,引發了我的興趣。既然他使用 C 語言實現,我決定嘗試用更便利的工具——ANTLR 來並行實踐。本文將示範如何使用 ANTLR 3.1 描述一個名為「Jerry」的簡單語言,並在 ANTLRWorks 中測試生成的解析器,獲取對應的解析樹。
關注解析器生成器的開發者對 ANTLR 應不陌生。作為「ANother Tool for Language Recognition」,它由 Terence Parr 教授開發,廣泛應用於 XRuby、Jython、SapphireSteel 的 Ruby 與 ActionScript IDE 等專案。ANTLR 繼承自 PCCTS,採用 LL(*) 遞歸下降算法,語法格式類似 EBNF,易於理解與維護。
根據編譯器構造實踐的任務需求,推導出的 Jerry 語法大致如下(完整語法檔 Jerry.g):
grammar Jerry;

program : statementList EOF ;

statementList : statement* ;

statement
    : expressionStatement
    | variableDeclaration
    | blockStatement
    | ifStatement
    | whileStatement
    | breakStatement
    | readStatement
    | writeStatement
    ;

expressionStatement : expression SEMICOLON ;

variableDeclaration
    : typeSpecifier Identifier ( LBRACK Integer RBRACK )* initializer?
      ( COMMA Identifier ( LBRACK Integer RBRACK )* initializer? )*
      SEMICOLON
    ;

typeSpecifier : INT | REAL ;

initializer : EQ ( expression | arrayLiteral ) ;

arrayLiteral
    : LBRACE ( expression | arrayLiteral ) ( COMMA ( expression | arrayLiteral ) )* RBRACE
    ;

blockStatement : LBRACE statementList RBRACE ;

ifStatement : IF LPAREN expression RPAREN statement ( ELSE statement )? ;

whileStatement : WHILE LPAREN expression RPAREN statement ;

breakStatement : BREAK SEMICOLON ;

readStatement : READ variableAccess SEMICOLON ;

writeStatement : WRITE expression SEMICOLON ;

variableAccess : Identifier ( LBRACK Integer RBRACK )* ;

expression
    : assignmentExpression
    | logicalOrExpression
    ;

assignmentExpression : variableAccess EQ expression ;

logicalOrExpression : logicalAndExpression ( OROR logicalAndExpression )* ;

logicalAndExpression : relationalExpression ( ANDAND relationalExpression )* ;

relationalExpression
    : additiveExpression ( relationalOperator additiveExpression )?
    | BANG relationalExpression
    ;

additiveExpression : multiplicativeExpression ( additiveOperator multiplicativeExpression )* ;

multiplicativeExpression : primaryExpression ( multiplicativeOperator primaryExpression )* ;

primaryExpression
    : variableAccess
    | Integer
    | RealNumber
    | LPAREN expression RPAREN
    | SUB primaryExpression
    ;

relationalOperator : LT | GT | EQEQ | LE | GE | NE ;

additiveOperator : ADD | SUB ;

multiplicativeOperator : MUL | DIV ;

// Lexer rules
LPAREN : '(' ; RPAREN : ')' ;
LBRACK : '[' ; RBRACK : ']' ;
LBRACE : '{' ; RBRACE : '}' ;
COMMA : ',' ; SEMICOLON : ';' ;
ADD : '+' ; SUB : '-' ; MUL : '*' ; DIV : '/' ;
EQEQ : '==' ; NE : '!=' ; LT : '<' ; LE : '<=' ; GT : '>' ; GE : '>=' ;
BANG : '!' ; ANDAND : '&&' ; OROR : '||' ; EQ : '=' ;
IF : 'if' ; ELSE : 'else' ; WHILE : 'while' ; BREAK : 'break' ;
READ : 'read' ; WRITE : 'write' ; INT : 'int' ; REAL : 'real' ;

Identifier : LetterOrUnderscore ( LetterOrUnderscore | Digit )* ;
Integer : Digit+ ;
RealNumber : Digit+ '.' Digit+ ;

fragment Digit : '0'..'9' ;
fragment LetterOrUnderscore : Letter | '_' ;
fragment Letter : ( 'a'..'z' | 'A'..'Z' ) ;

WS : ( ' ' | '\t' | '\r' | '\n' )+ { $channel = HIDDEN; } ;
Comment : '/*' ( options { greedy = false; } : . )* '*/' { $channel = HIDDEN; } ;
LineComment : '//' ~ ('\n'|'\r')* '\r'? '\n' { $channel = HIDDEN; } ;
雖然可以定義獨立的 indexExpression 規則並消除左遞歸,但 Jerry 僅允許陣列變數使用下標,因此直接在 variableAccess 中處理:Identifier ( '[' Integer ']' )*,簡化語法樹。
賦值表達式與 read 語句都需要左值,Jerry 語言中左值只能是變數訪問,故無需額外規則。
Jerry 中一元邏輯非 ! 的優先級低於所有算術與關係運算子,高於 ||。這導致 ! 1 != 1 || 1 == 1 在 Jerry 中合法並為 true,而在 Java 中因優先級不同而編譯錯誤。
\d+\.\d+,小數點前後必須有數字,無後綴。使用 ANTLRWorks 1.2.2 的 Interpreter 模式測試以下代碼:
// line comment
int i = 1, j;
int x = i + 2 * 3 - 4 / ( 6 - - 7 );
int array[2][3] = { { 0, 1, 2 }, { 3, 4, 6 } };
/* block comment */
while (i < 10) i = i + 1;
while (!x > 0 && i < 10) {
    x = x - 1;
    if (i < 5) break;
    else read i;
}
write x - j;
生成的解析樹如下圖所示:
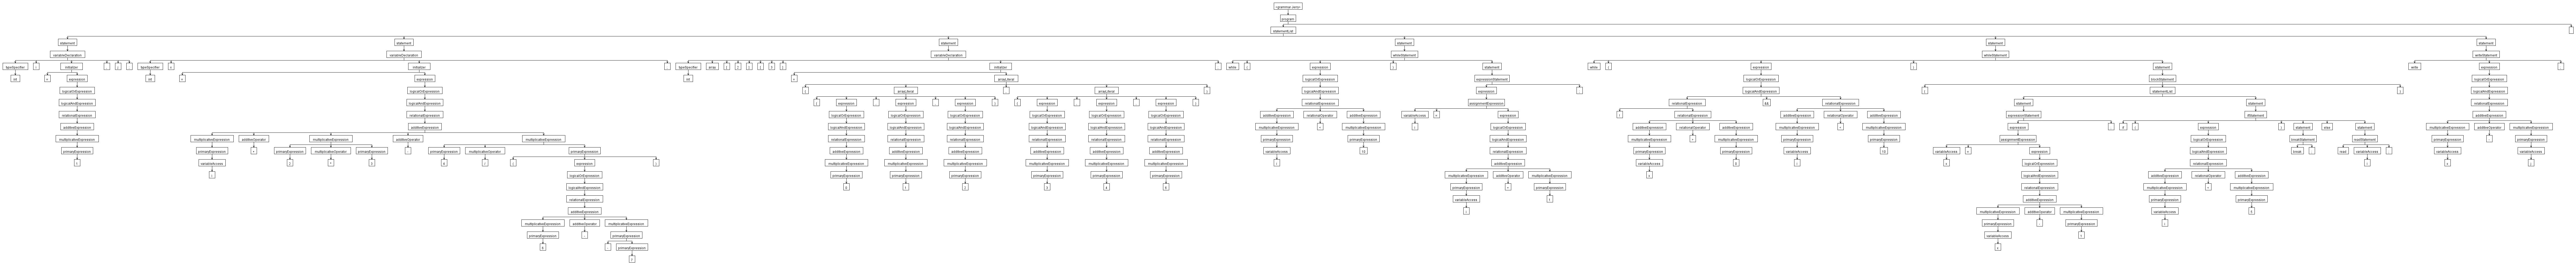
additiveExpression → multiplicativeExpression → primaryExpression)。這些冗餘不利於後續處理,下一步將介紹如何使用 ANTLR 的重寫規則將解析樹轉換為更乾淨的抽象語法樹(AST)。