將 volatile 讀/寫視為同一監視器鎖同步的單操作:
class VolatileExample {
    int a = 0; volatile boolean flag = false;
    void writer() { a = 1; flag = true; } // 1→2
    void reader() { if (flag) { int i = a; } } // 3→4
}
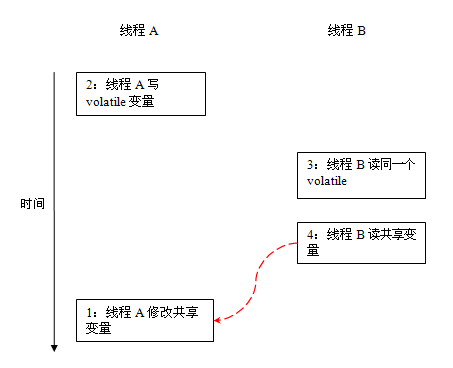
happens-before 鏈路:
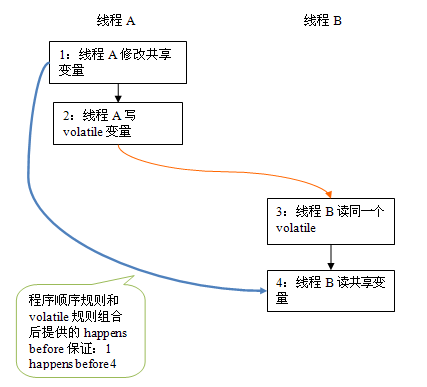
結果:線程 A 寫 flag 前對 a 的修改,線程 B 讀 flag 後立即可見。
| 操作 | 語義 | 效果示意 |
|---|---|---|
| volatile 寫 | 刷新本地內存共享變量至主內存 | 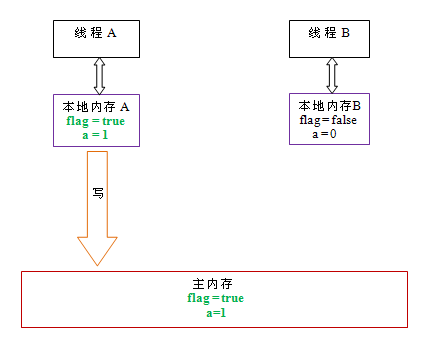 |
| volatile 讀 | 置本地內存無效,從主內存重讀 | 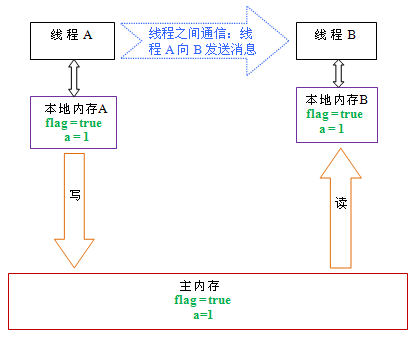 |
本質:線程 A 通過主內存向線程 B 發送消息。
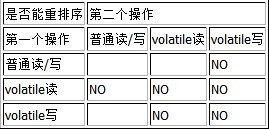
| 位置 | 屏障類型 | 目的 |
|---|---|---|
| volatile 寫前 | StoreStore | 確保普通寫在 volatile 寫前刷新 |
| volatile 寫後 | StoreLoad | 防止 volatile 寫與後續 volatile 讀/寫重排 |
| volatile 讀後 | LoadLoad + LoadStore | 禁止 volatile 讀與後續普通讀/寫重排 |
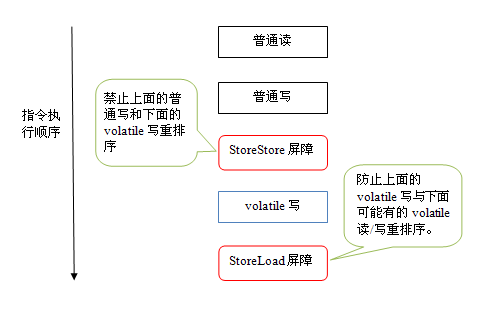
void readAndWrite() {
    int i = v1;  // volatile讀
    int j = v2;  // volatile讀
    a = i + j;   // 普通寫
    v1 = i + 1;  // volatile寫
    v2 = j * 2;  // volatile寫
}
優化後: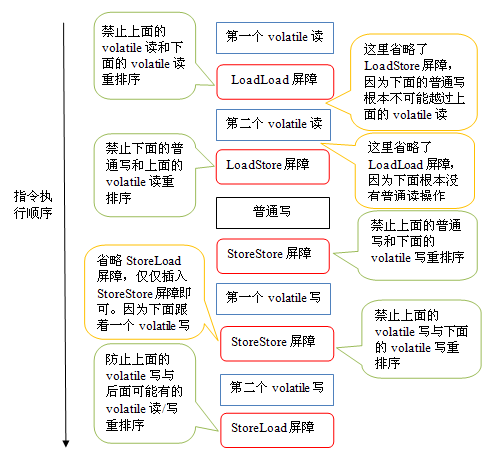
x86 僅允許 Store-Load 重排 → 僅保留 volatile 寫後的 StoreLoad 屏障: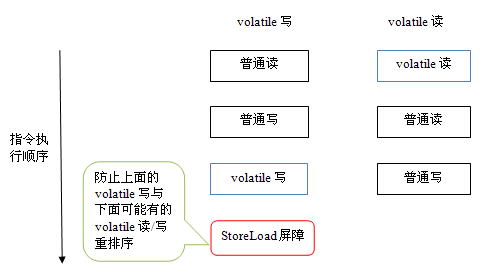
結論:x86 上 volatile 寫開銷遠大於讀(StoreLoad 成本高)。
舊模型允許 volatile 與普通變量重排:
a = 1;      // 1 普通寫
flag = true; // 2 volatile寫
// 可能重排為 2→1,導致讀線程見到 flag=true 但 a=0
增強目標:嚴格限制 volatile 與普通變量重排,使 volatile 寫-讀具備鎖釋放-獲取同等語義,提供輕量級線程通信機制。