成長型市場常存在多語言混雜資料(如印地語夾雜拉丁字母),文本分析前需先統一音譯至目標文字(如拉丁字母),再進行情感分析等後續處理。
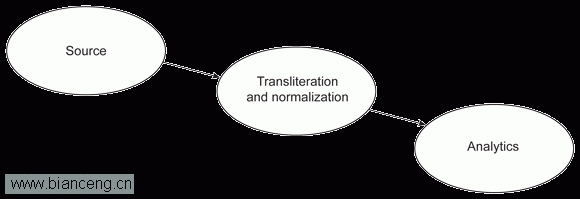
資料流:來源 → 音譯運算子 → 文本分析 → 輸出沉澱。
com.ibm.icu)。com.ibm.streams.operator.Operator 介面,核心邏輯於 process():
public class TransliterateOperator extends AbstractOperator {
    @Override
    public void process(StreamingInput input, Tuple tuple) {
        OperatorContext ctx = getOperatorContext();
        String srcLang = ctx.getParameterValues("sourceLanguage").get(0);
        String dstLang = ctx.getParameterValues("destLanguage").get(0);
        Transliterator t = Transliterator.getInstance(srcLang + "-" + dstLang);

        String text = tuple.getString("inp");
        String result = toBaseCharacters(t.transliterate(text));

        StreamingOutput out = getOutput(0);
        OutputTuple ot = out.newTuple();
        ot.setString("TransliteratedText", result);
        out.submit(ot);
    }

    private String toBaseCharacters(String s) {
        if (s == null || s.isEmpty()) return s;
        StringBuilder sb = new StringBuilder();
        for (char c : s.toCharArray()) {
            String n = Normalizer.normalize(String.valueOf(c), Normalizer.Form.NFKD);
            try { sb.append(new String(n.getBytes("UTF-8"), 0, 1)); }
            catch (UnsupportedEncodingException ignored) {}
        }
        return sb.toString();
    }
}
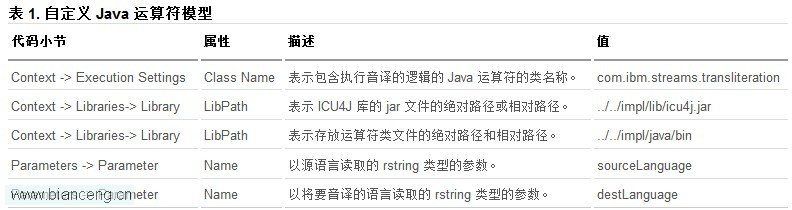
icu4j.jar。sourceLanguage、destLanguage(如 Hindi-Latin)。ustring,輸出 ustring TransliteratedText。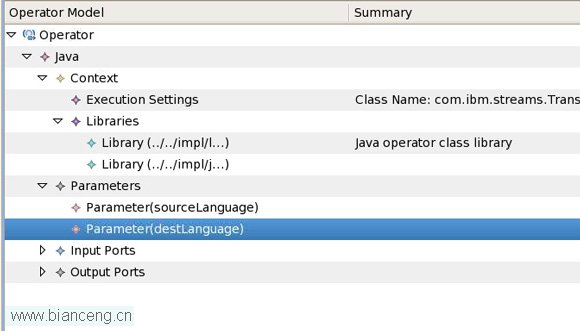
composite Main {
    graph
    stream SourceBlogs = InetSource() {
        param URIList: ["https://localblogs.com/fashionwear"];
        initDelay: 5.0; incrementalFetch: true; fetchIntervalSeconds: 60.0;
    }
    stream TransliteratedOutput = Transliterate(SourceBlogs) {
        param sourceLanguage: "Any"; destLanguage: "Latin";
    }
    stream Sentiment = TextExtractor(TransliteratedOutput) {
        param AQLFile: "getsentiment.aql";
    }
    () as Sink = FileSink(Sentiment) {
        param file: "output.txt"; format: csv; hasDelayField: false;
    }
}
Transliterator:getInstance("Hindi-Latin") 取得實例,transliterate() 執行轉換,無狀態。Normalizer:NFKD 分解格式,將重音字元拆解為基底字元+組合符號。支援語言對:Hindi-Latin、Arabic-Latin、Kannada-Latin、Telugu-Latin、Tamil-Latin 等。
輸入:  "mujhe xyz suit pasanda nahin aya"  (印地語羅馬拼音)
音譯:  "mujhe xyz suit pasanda nahin aya"  (已為拉丁字母,Normalizer 處理重音)
分析:  偵測到 "nahin"(否定詞)→ 情感:negative
自訂 Java 運算子結合 ICU4J,提供可部署於 InfoSphere Streams 的即時音譯能力,解決多語言文本分析的前置一致性問題。