什麼是垃圾收集器
垃圾收集器 (Garbage Collector, GC) 是垃圾回收算法的程序實現。我們常說的「算法」是理論模型,「收集器」是具體代碼實現,涉及線程模型、內存佈局、運行時協調等工程細節。本系列基於 HotSpot JVM (Oracle JDK 默認實現) 展開。
GC 算法回顧
| 算法 | 核心思想 | 優點 | 缺點 | 適用區域 |
|---|
| 標記-清除 | 標記存活,清除未標記 | 實現簡單 | 碎片化、效率低 | 年老代 |
| 標記-整理 | 標記存活,向一端移動 | 無碎片 | 移動開銷 | 年老代 |
| 復制算法 | 劃分兩塊,互相復制 | 無碎片、分配快 | 空間利用率 50% | 新生代 |
| 分代收集 | 按對象壽命分區 | 針對性優化 | 復雜 | 整個堆 |
收集器三大分類
1. 串行收集器
- 單 GC 線程
- 全程 Stop-the-world
- 實現:Serial (新生代)、Serial Old (年老代)
2. 並行收集器
- 多 GC 線程並行工作
- 全程 Stop-the-world
- 實現:ParNew、Parallel Scavenge (新生代)、Parallel Old (年老代)
3. 並發收集器
- GC 線程與用戶線程交替/同時運行
- 部分階段 Stop-the-world,大部分階段並發
- 實現:CMS (Concurrent Mark Sweep,年老代)
並行 vs 並發:核心區別
| 維度 | 並行 | 並發 |
|---|
| 定義 | 多任務同時執行 (多核) | 多任務交替執行 (單核時間片) |
| 硬件要求 | 多核多處理器 | 單核即可 |
| GC 線程 | 多線程同時回收 | GC 與用戶線程交替 |
| 停頓 | 整體縮短 | 拆分為多個短停頓 |
關鍵洞察:並行是並發的一種實現方式 (多核下)。CMS 的「並發」在多核上實際是 GC 線程與用戶線程並行運行;單核下通過時間片切換實現並發效果。
HotSpot 七大收集器 (含 G1)
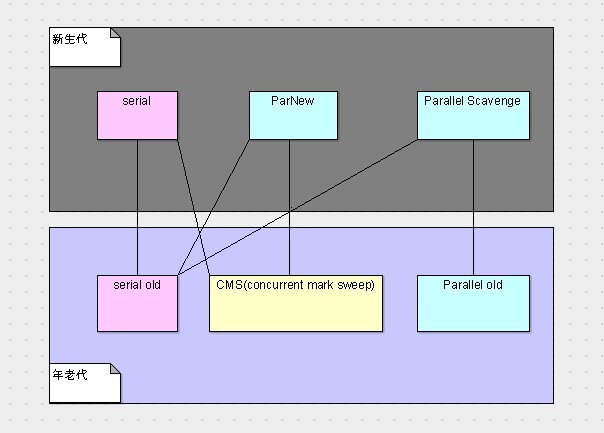
新生代收集器 (3款)
- Serial:復制算法,單線程
- ParNew:復制算法,多線程,CMS 唯一搭檔
- Parallel Scavenge:復制算法,多線程,吞吐量可控
年老代收集器 (3款)
- Serial Old:標記-整理,單線程
- Parallel Old:標記-整理,多線程,Parallel Scavenge 搭檔
- CMS:標記-清除,並發,低停頓
特殊收集器
- G1:面向服務端,分區並行,可預測停頓 (JDK 7+ 成熟,JDK 9+ 默認)
收集器兼容性規則
只有連線相連的組合才能工作 (共 6 種有效組合):
- Serial + Serial Old
- Serial + CMS (罕用)
- ParNew + Serial Old
- ParNew + CMS
- Parallel Scavenge + Serial Old
- Parallel Scavenge + Parallel Old
不兼容原因:線程模型衝突、內存佈局假設不同、同步機制不一致。
分代收集理論基礎
- 弱代假設:絕大多數對象朝生夕死
- 強代假設:熬過越多 GC 的對象越難死
- 跨代引用假設:跨代引用相對較少
因此:新生代用復制算法 (少量存活);年老代用標記-整理/清除 (大量存活);記錄跨代引用 (Remembered Set/Card Table) 避免全堆掃描。
查看當前 JVM 收集器
$ java -XX:+PrintCommandLineFlags -version
-XX:InitialHeapSize=... -XX:MaxHeapSize=... -XX:+UseParallelGC ...
或運行時:jinfo -flag UseParallelGC <pid>
總結
垃圾收集器是 GC 算法在 HotSpot 中的工程化實現。理解「串行/並行/並發」三種線程模型、「復制/標記-清除/標記-整理」三種算法在分代上的適用性、六大經典收集器的兼容性組合,是進入 JVM 調優世界的入場券。下一步將深入各收集器具體實現細節、參數調節與場景實戰。
- 上一篇文章: JVM 垃圾收集器詳解:六大收集器特性、組合策略與場景選型
- 下一篇文章: JVM 記憶體管理:分代收集算法深度解析
Copyright ©
程式碼之家 All Rights Reserved