Server returned HTTP response code: 403。link、language 等在 image 節點後出現時會被漏解析(標記位邏輯缺陷)。修改 org.gnu.stealthp.rsslib.RssParser.setXmlResource(URL):
URLConnection con = u.openConnection();
// 新增:偽裝瀏覽器 UA
con.setRequestProperty("User-Agent", "Mozilla/4.0 (compatible; MSIE 5.0; Windows NT; DigExt)");
con.setReadTimeout(10000);
// 原有邏輯...
is = new InputSource(new UnicodeReader(con.getInputStream(), Charset.guess(u)));
同步修改 org.mozilla.intl.chardet.Charset.guess(URL),同樣注入 UA 後再獲取輸入流。
在 org.gnu.stealthp.rsslib.RssObject 中新增:
public String getSummary() {
    String summary = getDescription(); // RSS 無 summary,退回 description
    if (summary.length() >= 300) summary = summary.substring(0, 300);
    // 移除 HTML 標籤與實體
    String regEx = "\\s|<[^>]+>|&\\w{1,5};";
    summary = Pattern.compile(regEx, Pattern.CASE_INSENSITIVE).matcher(summary).replaceAll("");
    if (summary.length() >= 100) summary = summary.substring(0, 100);
    return summary + "...";
}問題根因:RSSHandler.startElement() 遇到 image、textinput 等子節點時設 reading_chan = false,導致後續同層級節點 (link/language) 不再解析。
修復:在 endElement() 中,針對這些子節點結束時重置 reading_chan = true:
if (tagIsEqual(qName, IMAGE_TAG)) {
    reading_image = false;
    reading_chan = true; // 關鍵:恢復 channel 解析狀態
}
if (tagIsEqual(qName, TEXTINPUT_TAG)) {
    reading_input = false;
    reading_chan = true;
}myrsslib4j.jar。org.javali.util.test.RssNewsFetcher 加入 CSDN 與網易博客 RSS,控制台輸出標題、鏈接、摘要均正常。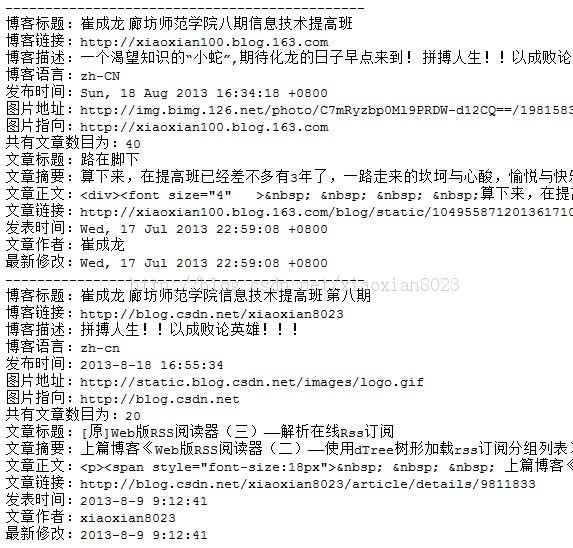
專案託管於 Google Code:https://code.google.com/p/myrsslib4j/,歡迎 Fork 與 Issue。
myrsslib4j 仍僅支援 RSS 格式。下一篇將發布 myrome(基於 Rome 修改),完美支援 RSS 1.0/2.0 + Atom 1.0,成為閱讀器最終解析引擎。