無鎖程式設計(Lock-Free)以高併發效能著稱,核心仰賴 CAS(Compare-And-Swap)原子操作。但在輕度、中度爭用下表現優異的 CAS,卻在高爭用場景下成為擴展性的殺手。本文深入剖析 CAS 的硬體層面機制,揭示其為何會導致效能崩塌,並以實測數據佐證。
x86 架構下,CAS 對應 CMPXCHG 指令(需加 LOCK 前綴)。Intel/AMD CPU 採用 MESI/MOESI 快取一致性協定:單核心操作快取行成本低,但多核心爭用同一快取行時,會觸發快取失效與總線鎖定,導致 CAS 操作延遲劇增。快取爭用正是程式擴展性的頭號殺手,而 CAS 比一般記憶體操作更嚴重,因為它:
雖然鎖機制(如 .NET Monitor 使用兩次 CAS)備受詬病,但合格開發者懂得縮短鎖持有時間。相較之下,大量頻繁的 CAS 操作反而更嚴重地破壞擴展性。原因在於:共享記憶體是根本瓶頸,並發控制需要 CAS,CAS 昂貴,故共享記憶體昂貴。樂觀失敗重試、快取失效、記憶體重排序需顯式柵欄,疊加起來往往比正確實作的鎖更差。
counter++(非執行緒安全,基準線)LOCK INC 指令Interlocked.CompareExchange 自旋重試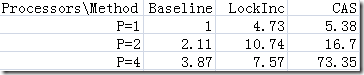
隨核心數增加,所有方法效能皆惡化,主因為記憶體爭用。CAS 迴圈在高爭用下表現最差。
在迴圈中插入無操作函數呼叫(延遲共享記憶體存取):
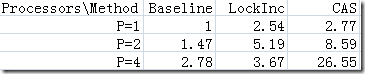
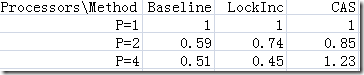
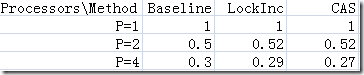
64 次呼叫達到加速極限,再多反而無益。這證明:降低共享記憶體存取頻率,遠比優化 CAS 本身有效。
使用 Interlocked 系列 API 時,共享變數不需標記 volatile。因為 API 內部已包含完整記憶體柵欄與硬體原子指令。若強加 volatile,編譯器會發出警告(CS0420),可用 #pragma warning disable 0420 抑制,或直接移除 volatile。CLR 記憶體模型保證了正確性。
無鎖技術、事務記憶體、讀寫鎖鮮能根本改善擴展性。真正的出路在於:極力避免共享狀態。若必須共享,謹慎評估 CAS 使用頻率,優先考慮資料分區、非同步訊息傳遞、Actor 模型等無共享架構。天下沒有免費午餐,CAS 也不例外。