背景:單核到多核的範式轉移
CLR ThreadPool 早期設計針對單核:工作項佇列 + 單一鎖保護 + 循序取用。多核帶來新挑戰:鎖爭用、快取爭用、上下文切換、NUMA 架構感知。ThreadPool 正整合並行框架 (TPL) 內建化處理常見問題。
常見效能殺手
公平性 vs 效能
- FIFO 公平調度 ≠ 最佳效能
- 熱資料留在快取 (LIFO) 效能更好
- 新版採用 工作竊取演算法:每核一佇列,冷任務可被竊取執行,兼顧公平與局部性
鎖爭用
- 每次入隊/出隊需鎖
- 大量短小工作項 → 高頻鎖操作
- 線程喚醒風暴:工作到達時喚醒所有線程搶鎖
- 緩解:限制釋放線程數、移除部分鎖、無鎖佇列
同步原語開銷
- 多核上 Mutex 公平性機制反而損害效能
- Monitor 自旋 vs 等待權衡
- 讀寫鎖選型取決於讀寫比例
工作負載特性差異
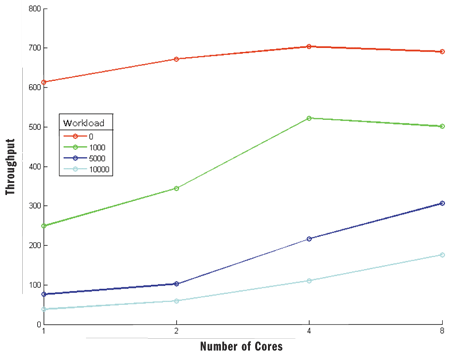
- CPU 密集型:受調度/同步影響大
- I/O 密集型:受並發層級控制影響大
- 實驗證明:盲目增加核心不一定提升吞吐量
記憶體階層與 NUMA
- 遠端記憶體存取延遲高
- ThreadPool 尚無 NUMA 感知
- 工作竊取天然保留任務在同節點 (本地入隊/出隊)
危險優化
通用優化可能對簡單應用增加開銷。有時「浪費」 CPU 週期 (主動讓步) 反而比榨乾 CPU 吞吐量更高。
噪音干擾
真實環境多進程爭用資源,甚至多 AppDomain 相互干擾,導致效能測量變異大。
並發控制核心:執行緒數量的動態平衡
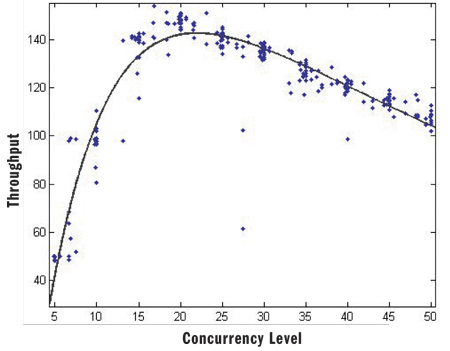
- 理論峰值:雙核 200 items/sec (100ms/item, 10ms CPU)
- 實測峰值:並發度 ~15 達 150 items/sec,再增則因上下文切換下降
- CPU 100% ≠ 最佳吞吐量 (可能在處理無效線程)
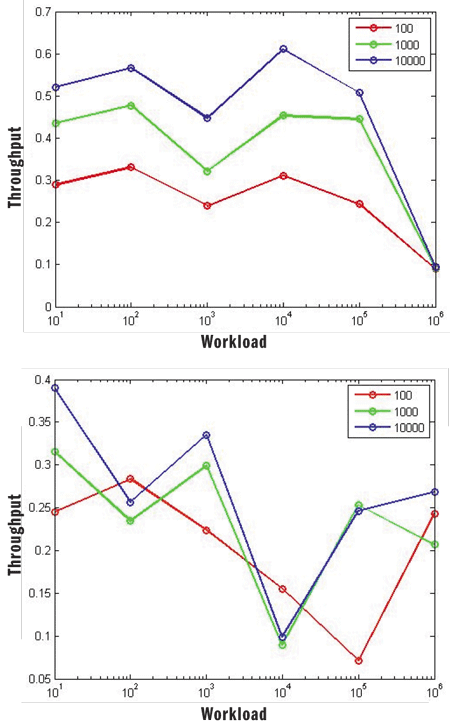
- 現有 ThreadPool:緩慢增長 (每 250ms 一線程),吞吐量低但穩定
- 激進調整:吞吐量波動大、噪音多,需針對負載類型客製化
手動優化實證
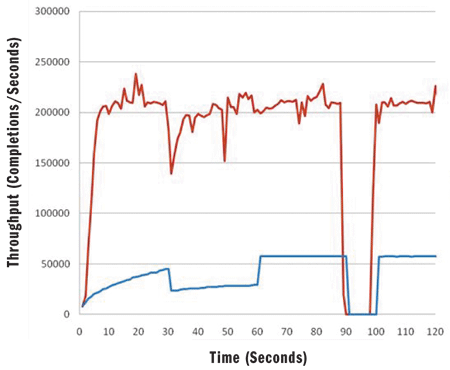
- 紅線:快速注入線程、動態調整參數
- 藍線:預設 ThreadPool 保守策略
- 關鍵差異:主動控制並發度 vs 被動反應
未來:任務並行庫 (TPL) 與自適應 ThreadPool
- TPL 提供
Parallel.For、Task、PLINQ 高層抽象
- 新版 ThreadPool 內建工作竊取、山丘演算法自動調整並發度
- 目標:減少手動調優、提升預設效能、支援 NUMA
遞歸並行化陷阱
分治遞歸 (如 QuickSort) 在 ThreadPool 易死鎖:外層任務等待內層,線程池耗盡。解法:TaskCreationOptions.LongRunning 或自定義排程器。
專家聯繫
問題回報:clrinout@microsoft.com
Erika Fuentes (PM) & Eric Eilebrecht (Senior SDE) - CLR 併發核心團隊