網頁爬蟲是資訊檢索、資料探勘的核心基建。本文深入剖析一個支援多執行緒併發控制、非同步 I/O、超時重試、深度優先/廣度優先切換的生產級爬蟲核心架構,適合需大規模抓取、穩定性要求高的專案參考。
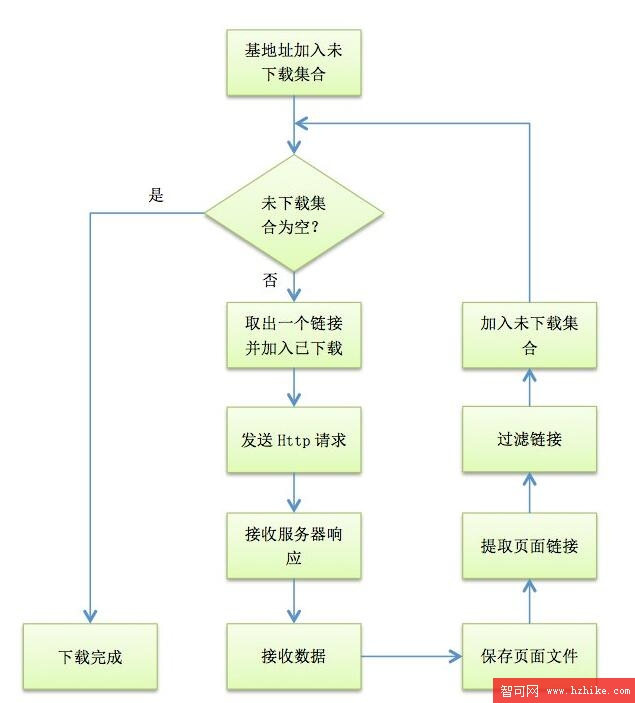
流程核心:URL 調度器 → 非同步下載器 → 內容解析器 → URL 去重/過濾 → 回存調度器,形成閉環。
// 待下載 URL:Key=URL, Value=Depth (相對種子 URL 的層級)
private readonly Dictionary<string, int> _urlsUnload = new Dictionary<string, int>();

// 已下載 URL:防重複、支援斷點續爬
private readonly Dictionary<string, int> _urlsLoaded = new Dictionary<string, int>();

// 同步鎖:保護雙佇列的執行緒安全
private readonly object _locker = new object();
採用 Dictionary 而非 Queue 的原因:需快速 ContainsKey 判重、且需保存深度資訊供策略判斷。
雖然現代建議使用 HttpClient,但 HttpWebRequest 的 BeginGetResponse / EndGetResponse (APM) 在 .NET Framework 時代仍具高效能、低記憶體佔用優勢。
private bool[] _reqsBusy; // 每個邏輯工作槽是否忙碌
private int _reqCount = 4; // 最大併發數

private void DispatchWork()
{
    if (_stop) return;

    for (int i = 0; i < _reqCount; i++)
    {
        if (!_reqsBusy[i])
        {
            RequestResource(i); // 配發任務給空閒槽
        }
    }
}設計精華:無額外 Thread,以邏輯槽位模擬工作執行緒,完成即釋放槽位並遞迴呼叫 DispatchWork 形成「拉取式」調度,自然避免線程池飢餓。
private void RequestResource(int index)
{
    string url; int depth;
    lock (_locker)
    {
        if (_urlsUnload.Count == 0)
        {
            _workingSignals.FinishWorking(index); // 標記該槽永久結束
            return;
        }
        _reqsBusy[index] = true;
        _workingSignals.StartWorking(index);

        // 取出第一筆 (可改為 PriorityQueue 依深度/權重排序)
        url = _urlsUnload.Keys.First();
        depth = _urlsUnload[url];
        _urlsLoaded.Add(url, depth);
        _urlsUnload.Remove(url);
    }

    var req = (HttpWebRequest)WebRequest.Create(url);
    req.Method = _method; // GET/POST
    req.Accept = _accept;
    req.UserAgent = _userAgent;
    req.Timeout = _maxTime;

    // 封裝回呼所需上下文
    var state = new RequestState(req, url, depth, index);

    // 非同步發送,註冊超時監控
    var ar = req.BeginGetResponse(ReceivedResource, state);
    ThreadPool.RegisterWaitForSingleObject(ar.AsyncWaitHandle, TimeoutCallback, state, _maxTime, true);
}class RequestState
{
public const int BufferSize = 131072; // 128KB
public byte[] Data { get; } = new byte[BufferSize];
public StringBuilder Html { get; } = new StringBuilder();
public HttpWebRequest Req { get; }
public string Url { get; }
public int Depth { get; }
public int Index { get; } // 工作槽編號
public Stream ResStream { get; set; }
public RequestState(HttpWebRequest req, string url, int depth, int index)
{
Req = req; Url = url; Depth = depth; Index = index;
}
}private void TimeoutCallback(object state, bool timedOut)
{
if (!timedOut) return;
var rs = state as RequestState;
if (rs == null) return;
rs.Req.Abort(); // 強制中斷 TCP 連線
_reqsBusy[rs.Index] = false;
DispatchWork(); // 立即嘗試派發下一個任務
}private void ReceivedResource(IAsyncResult ar)
{
var rs = (RequestState)ar.AsyncState;
try
{
var res = (HttpWebResponse)rs.Req.EndGetResponse(ar);
if (_stop || res.StatusCode != HttpStatusCode.OK)
{
Cleanup(rs); return;
}
rs.ResStream = res.GetResponseStream();
// 遞迴式非同步讀取:每讀完一塊觸發 ReceivedData
rs.ResStream.BeginRead(rs.Data, 0, rs.BufferSize, ReceivedData, rs);
}
catch (WebException) { Cleanup(rs); }
}
private void ReceivedData(IAsyncResult ar)
{
var rs = (RequestState)ar.AsyncState;
try
{
int read = rs.ResStream.EndRead(ar);
if (_stop) { Cleanup(rs); return; }
if (read > 0)
{
// 將位元組轉字串累加
using (var ms = new MemoryStream(rs.Data, 0, read))
using (var sr = new StreamReader(ms, _encoding))
rs.Html.Append(sr.ReadToEnd());
// 繼續讀下一塊
rs.ResStream.BeginRead(rs.Data, 0, rs.BufferSize, ReceivedData, rs);
}
else // read == 0 代表串流結束
{
string html = rs.Html.ToString();
SaveContents(html, rs.Url);
var links = GetLinks(html);
AddUrls(links, rs.Depth + 1);
_reqsBusy[rs.Index] = false;
DispatchWork();
}
}
catch { Cleanup(rs); }
}private Timer _checkTimer;
private void StartDownload()
{
_checkTimer = new Timer(CheckFinish, null, 0, 300); // 300ms 檢查一次
DispatchWork();
}
private void CheckFinish(object state)
{
if (_workingSignals.IsFinished()) // 所有槽位皆為 Finished
{
_checkTimer.Dispose();
_checkTimer = null;
DownloadFinish?.Invoke(this, _urlsLoaded.Count);
}
}// 簡單儲存 HTML 到檔案
private void SaveContents(string html, string url)
{
if (string.IsNullOrEmpty(html)) return;
string path = Path.Combine(_path, $"{_index++}.txt");
File.WriteAllText(path, html);
ContentsSaved?.Invoke(this, new SavedEventArgs(path, url));
}
// 事件定義
public event EventHandler<SavedEventArgs> ContentsSaved;
public event EventHandler<int> DownloadFinish;private string[] GetLinks(string html)
{
const string pattern = @"https://([\w-]+\.)+[\w-]+(/[\w- ./?%&=]*)?";
var regex = new Regex(pattern, RegexOptions.IgnoreCase);
return regex.Matches(html).Cast<Match>().Select(m => m.Value).ToArray();
}private void AddUrls(string[] urls, int depth)
{
if (depth >= _maxDepth) return; // 1. 深度限制
foreach (var raw in urls)
{
string url = raw.Trim().TrimEnd('/');
if (!UrlAvailable(url)) continue; // 2. 去重 + 靜態資源過濾
if (url.Contains(_baseUrl)) // 3. 站內/站外分流
_urlsUnload.Add(url, depth);
else
HandleExternalLink(url); // 可記錄、忽略或另存
}
}
private bool UrlAvailable(string url)
{
if (UrlExists(url)) return false; // 已在待爬/已爬集合
// 過濾圖片、CSS、JS、字型等靜態資源
string lower = url.ToLower();
if (lower.EndsWith(".jpg") || lower.EndsWith(".png") || lower.EndsWith(".gif") ||
lower.EndsWith(".css") || lower.EndsWith(".js") || lower.EndsWith(".woff"))
return false;
return true;
}
private bool UrlExists(string url) =>
_urlsUnload.ContainsKey(url) || _urlsLoaded.ContainsKey(url);public string RootUrl
{
set
{
if (!value.Contains("https://")) value = "https://" + value;
_rootUrl = value;
_baseUrl = _rootUrl.Replace("www.", "").Replace("https://", "").TrimEnd('/');
}
}| 原架構 | 建議升級 | 效益 |
|---|---|---|
| HttpWebRequest APM | HttpClient + async/await | 語法簡潔、自動連線池、支援 HTTP/2 |
| Dictionary + Lock | ConcurrentDictionary / Channel<T> | 無鎖高併發、背壓控制 |
| 自訂 Timer 輪詢 | Task.WhenAll / IAsyncEnumerable | 原生非同步完成通知 |
| Regex 解析 HTML | AngleSharp / HtmlAgilityPack | 容錯率高、支援 CSS Selector |
| 檔案系統儲存 | EF Core / Dapper + PostgreSQL | 結構化查詢、斷點續爬、分散式擴展 |
本架構展示了「有限狀態機 + 非同步 I/O + 生產者消費者」在爬蟲領域的經典落地。理解其槽位調度、串流分塊讀取、超時保護、雙佇列去重四大核心機制,即可舉一反三,構建適應現代雲原生環境的高效能分散式爬蟲系統。