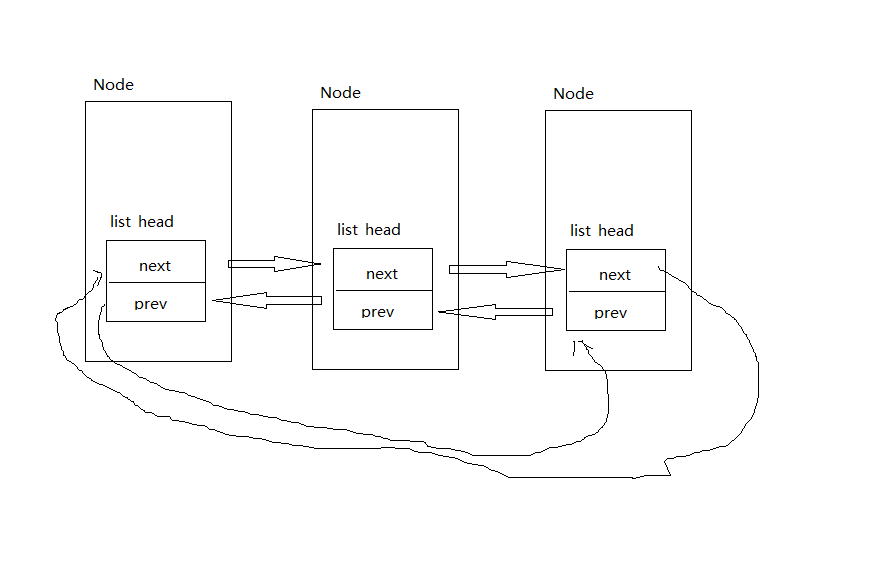
循環單向鏈表與普通單向鏈表的核心差異在於「尾節點指向頭節點」,形成閉環。這意味著遍歷終止條件從 NULL != pNode 變為 pStart != pCurrent,且任意節點均可作為入口。本文重點解析列印、插入、刪除三大操作在循環結構下的邏輯變化。
void print_data(const LINK_NODE* pLinkNode) {
    if (NULL == pLinkNode) return;
    LINK_NODE* pIndex = pLinkNode->next;
    printf("%d\n", pLinkNode->data); // 先印頭節點
    while (pLinkNode != pIndex) {  // 回到頭節點停止
        printf("%d\n", pIndex->data);
        pIndex = pIndex->next;
    }
}
同樣邏輯適用於 find、count 等遍歷函式。
STATUS insert_data(LINK_NODE** ppLinkNode, int data) {
    if (NULL == ppLinkNode) return FALSE;
    LINK_NODE* pNode = create_link_node(data); // 假設已有建立函式
    assert(NULL != pNode);

    if (NULL == *ppLinkNode) { // 空鏈表:節點指向自己
        pNode->next = pNode;
        *ppLinkNode = pNode;
        return TRUE;
    }
    if (NULL != find_data(*ppLinkNode, data)) return FALSE; // 假設無重複值

    // 非空鏈表:插入頭節點之後(頭插法變體)
    pNode->next = (*ppLinkNode)->next;
    (*ppLinkNode)->next = pNode;
    return TRUE;
}差異點:
a) 空鏈表時新節點 next 指向自己
b) 插入時不再遍歷至尾端,直接在頭節點後插入,維持環狀結構
STATUS delete_data(LINK_NODE** ppLinkNode, int data) {
    if (NULL == ppLinkNode || NULL == *ppLinkNode) return FALSE;
    LINK_NODE* pIndex = find_data(*ppLinkNode, data);
    if (NULL == pIndex) return FALSE;
    LINK_NODE* prev = NULL;

    if (pIndex == *ppLinkNode) { // 刪除頭節點
        if (pIndex == pIndex->next) { // 僅剩一個節點
            *ppLinkNode = NULL;
        } else { // 多節點:需找到尾節點修正其 next
            prev = pIndex->next;
            while (pIndex != prev->next) prev = prev->next;
            prev->next = pIndex->next;
            *ppLinkNode = pIndex->next;
        }
    } else { // 刪除非頭節點:同樣需從頭找前驅
        prev = pIndex->next;
        while (pIndex != prev->next) prev = prev->next;
        prev->next = pIndex->next;
    }
    free(pIndex);
    return TRUE;
}關鍵點:
a) 單節點刪除後設為 NULL
b) 刪除頭節點時必須遍歷找到尾節點修正 next
c) 刪除非頭節點同樣需遍歷尋找前驅節點
循環鏈表消除了 NULL 終點,賦予任意節點入口優勢,但也要求開發者在插刪操作時更精確地維護環狀結構完整性。掌握「尋找前驅需遍歷」與「頭尾連接點處理」是關鍵。