KMP算法將朴素匹配的O(mn)降至O(m+n),核心在於預計算模式串的覆蓋函數(next數組/失敗函數),失配時直接跳過必失配位置。本文從朴素算法切入,逐步推導覆蓋函數定義、遞推計算、匹配流程,附帶完整C++代碼。
NAIVE-STRING-MATCHER(T, P)
n ← |T|, m ← |P|
for s ← 0 to n-m:
    if P[1..m] = T[s+1..s+m]: print s
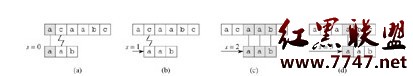
最壞情況(如T=aaaaaaaaaab、P=aaaaab)每次失配都回退s,重複比較已匹配前綴,時間O((n-m+1)m)。
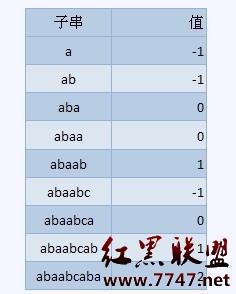
定義:對模式串P[0..j],overlay[j] = 最長真前綴同時為後綴的長度。
若無匹配則-1。
例:P=abaabcaba
| j | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| P[j] | a | b | a | a | b | c | a | b | a |
| overlay | -1 | -1 | 0 | 1 | 2 | -1 | 0 | 1 | 2 |
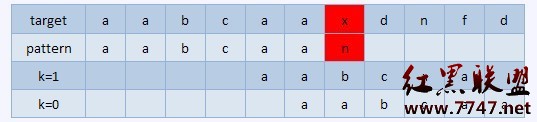
已匹配j字符,失配於j+1。
新對齊位置:j - overlay[j]。
關鍵:overlay[j]必須取最大值,否則會漏過合法匹配位置。
void compute_overlay(const string &P, vector<int> &ov) {
    int m = P.size();
    ov.assign(m, -1);
    for (int i = 1; i < m; i++) {
        int k = ov[i-1];           // 上一位置的覆蓋長度
        while (k >= 0 && P[i] != P[k+1])  // 失配則遞推縮短
            k = ov[k];
        if (P[i] == P[k+1]) ov[i] = k + 1;  // 匹配則延長
        else ov[i] = -1;
    }
}
邏輯:嘗試在已知最長覆蓋基礎上延長;失配則退回次長覆蓋(ov[k]),繼續嘗試。
int kmp_match(const string &T, const string &P) {
    vector<int> ov; compute_overlay(P, ov);
    int n = T.size(), m = P.size();
    int i = 0, j = 0;  // i:文本索引, j:模式索引
    while (i < n && j < m) {
        if (j == -1 || T[i] == P[j]) { i++; j++; }
        else j = ov[j];  // 失配跳轉
    }
    return (j == m) ? i - m : -1;
}
模式指針j從不回退,文本指針i單調遞增,總比較次數≤2n。
#include <iostream>
#include <string>
#include <vector>
using namespace std;

vector<int> buildNext(const string &P) {
    int m = P.size();
    vector<int> next(m, -1);
    for (int i = 1, k = -1; i < m; i++) {
        while (k >= 0 && P[i] != P[k+1]) k = next[k];
        if (P[i] == P[k+1]) k++;
        next[i] = k;
    }
    return next;
}

int kmpSearch(const string &T, const string &P) {
    if (P.empty()) return 0;
    vector<int> next = buildNext(P);
    for (int i = 0, j = 0; i < (int)T.size(); i++) {
        while (j > 0 && T[i] != P[j]) j = next[j-1] + 1;
        if (T[i] == P[j]) j++;
        if (j == (int)P.size()) return i - j + 1;
    }
    return -1;
}

int main() {
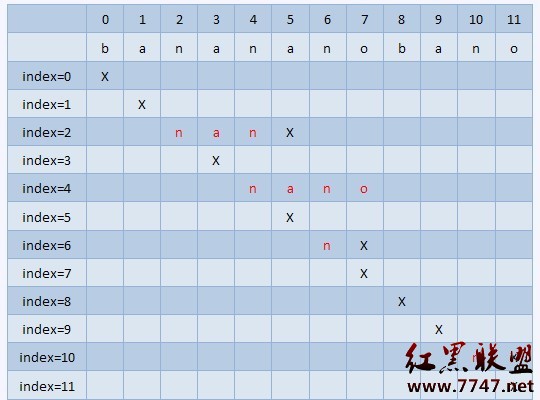
    string T = "banananobano", P = "nano";
    cout << "首次匹配位置: " << kmpSearch(T, P) << endl;  // 輸出 4
    return 0;
}
P[j] == P[next[j]],可設nextval[j] = nextval[next[j]],失配時直接跳過相同字符,進一步減少比較。KMP 是字符串算法的入門經典,理解「預處理模式串自我信息、失配不回退文本」的思想,對學習BM、Sunday、AC自動機等高級算法大有裨益。