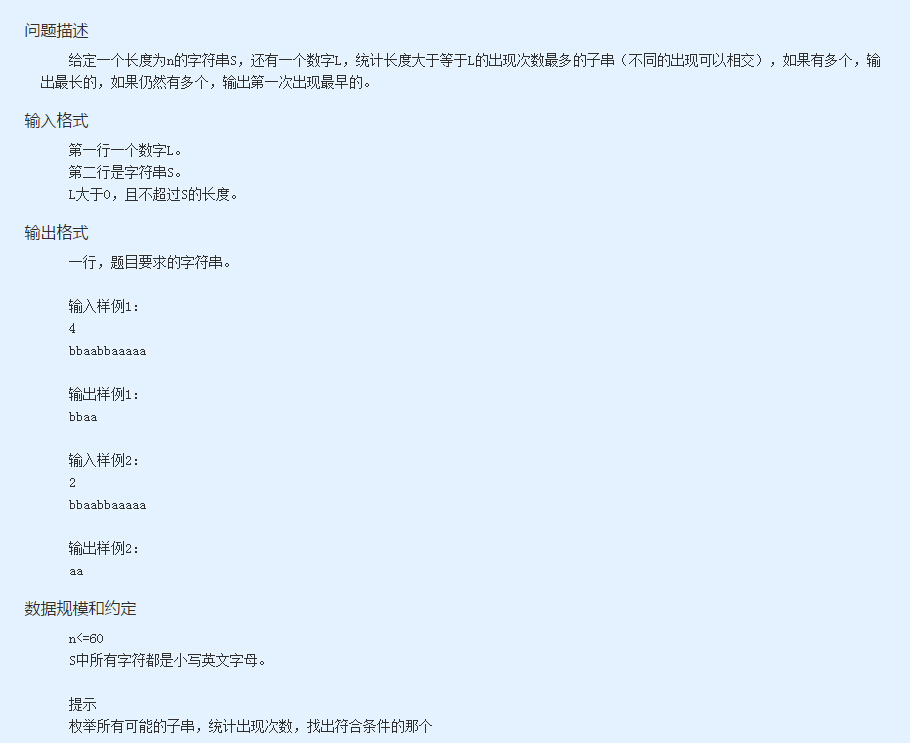
給定一個字符串和最小長度 L,統計所有長度 ≥ L 的子串出現頻率,輸出頻率最高者(多解輸出任一)。採用暴力枚舉 + 結構體存儲 + 冒泡排序實現。
l 和目標字符串 strl_temp 從 strlen(str) 遞減至 lisubstr[0].sstrstruct sub_str {
char sstr[61];
int len;
int times;
};
struct sub_str substr[1830]; // 最大子串數:60+59+...+1=1830
int sstr_num = 0;
// 枚舉所有符合長度的子串
for (l_temp = str_len; l_temp >= l; l_temp--) {
for (i = 0; i <= str_len - l_temp; i++) {
// 提取子串到 sstr_temp
for (j = i, k = 0; j < i + l_temp; j++, k++)
sstr_temp[k] = str[j];
// 查找是否已存在
for (k = 0; k < sstr_num; k++)
if (strcmp(sstr_temp, substr[k].sstr) == 0) {
substr[k].times++;
break;
}
// 新子串插入
if (k == sstr_num) {
strcpy(substr[sstr_num].sstr, sstr_temp);
substr[sstr_num].len = l_temp;
substr[sstr_num].times = 1;
sstr_num++;
}
memset(sstr_temp, 0, sizeof(sstr_temp));
}
}
// 冒泡排序(按 times 降序)
for (i = 0; i < sstr_num - 1; i++)
for (j = i; j < sstr_num; j++)
if (substr[j].times > substr[i].times)
swap(substr[i], substr[j]); // 結構體整體交換
puts(substr[0].sstr);