POSIX 正則表達式 API (regex.h) 是 C 語言處理複雜字串匹配、擷取、替換的標準工具。本文從基礎語法到完整編譯執行範例,詳細說明 regcomp、regexec、regmatch_t 結構體使用、捕獲群組擷取、錯誤處理與常見陷阱,並提供可直接編譯的完整程式碼。
| 元字符 | 說明 | 範例 |
|---|---|---|
. | 任意單一字符(除換行) | a.c 匹配 abc, axc |
[] | 字符集合 | [aeiou] 匹配任一母音 |
[^] | 排除字符集合 | [^0-9] 匹配非數字 |
- | 範圍 | [a-zA-Z0-9] 字母數字 |
\w | 單詞字符 [a-zA-Z0-9_] | |
\d | 數字 [0-9] | |
\s | 空白字符 | |
{m,n} | 量詞:m 到 n 次 | \d{3,5} 3-5 位數字 |
() | 捕獲群組 | (\w+)=(\w+) 鍵值對 |
| | 或 | cat|dog |
^ $ | 行首/行尾 |
// 1. 編譯正則
regex_t regex;
int ret = regcomp(®ex, pattern, REG_EXTENDED | REG_NEWLINE);
if (ret != 0) {
char errbuf[1024];
regerror(ret, ®ex, errbuf, sizeof(errbuf));
fprintf(stderr, "Regex compile failed: %s\n", errbuf);
return -1;
}
// 2. 執行匹配
regmatch_t matches[10]; // matches[0] 為整體匹配,[1]... 為捕獲群組
ret = regexec(®ex, string, 10, matches, 0);
if (ret == REG_NOMATCH) { /* 無匹配 */ }
else if (ret != 0) { /* 執行錯誤 */ }
// 3. 擷取捕獲群組
for (int i = 0; i < 10; i++) {
if (matches[i].rm_so == -1) break; // 無匹配
int start = matches[i].rm_so;
int end = matches[i].rm_eo;
int len = end - start;
char buf[256];
strncpy(buf, string + start, len);
buf[len] = '\0';
printf("Group %d: %s\n", i, buf);
}
// 4. 釋放資源
regfree(®ex);
#include <stdio.h>
#include <sys/types.h>
#include <regex.h>
#include <string.h>
int main() {
const char *p_str = " Url = www.google.com.hk ;";
const char *p_reg = "[[:space:]]*([^[:space:]]+)[[:space:]]*=[[:space:]]*([^[:space:]]+)[[:space:]]*;";
regex_t reg;
regmatch_t matchs[10];
int r, i;
// 編譯:REG_EXTENDED 啟用擴展正則(支援 + ? {m,n} 等)
r = regcomp(®, p_reg, REG_EXTENDED);
if (r != 0) {
char err[256];
regerror(r, ®, err, sizeof(err));
printf("Compile error: %s\n", err);
return 1;
}
// 執行匹配
r = regexec(®, p_str, 10, matchs, 0);
if (r != 0) {
if (r == REG_NOMATCH) printf("No match\n");
else {
char err[256];
regerror(r, ®, err, sizeof(err));
printf("Exec error: %s\n", err);
}
regfree(®);
return 1;
}
// 輸出所有捕獲群組
for (i = 0; i < 10; i++) {
int start = matchs[i].rm_so;
int end = matchs[i].rm_eo;
if (start == -1) break;
int len = end - start;
char buf[256];
strncpy(buf, p_str + start, len);
buf[len] = '\0';
printf("match[%d]: %s\n", i, buf);
}
regfree(®);
return 0;
}
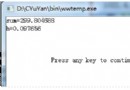
match[0]:  Url = www.google.com.hk ;
match[1]: Url
match[2]: www.google.com.hk
REG_EXTENDED 必須啟用:否則 {m,n}、+、?、| 等擴展語法無效,僅支援基本正則(BRE)。matches[0] 是整體匹配:捕獲群組從 matches[1] 開始。rm_so == -1 表示該群組未參與匹配:需檢查後再存取。\ 在 C 字串需寫成 \\。建議使用原始字串字面量(C23)或外部配置檔讀取。regcomp 開銷大,相同正則重複使用時應快取編譯後的 regex_t。regex_t 非執行緒安全,多執行緒需各自編譯或加鎖。regexec 位置資訊實現。| 庫 | 優點 | 缺點 | 適用場景 |
|---|---|---|---|
| POSIX regex.h | 標準、無依賴、Unicode 支援(當前 locale) | API 繁瑣、無替換、效能中等 | 標準 C 專案、嵌入式系統 |
| PCRE / PCRE2 | Perl 相容、功能豐富、JIT 加速 | 外部依賴、授權 (BSD) | 複雜文本處理、高效能需求 |
| RE2 (Google) | 線性時間保證、安全、C++11 | C API 需包裝、功能受限 | 非信任輸入、高併發服務 |
| SLRE / TinyRegex | 極輕量、單檔案、嵌入式友善 | 功能子集、無 {m,n} 貪婪模式 | 微控制器、極度受限環境 |
掌握 regex.h 讓你在無法引入重型依賴的環境中,依然能優雅地解決複雜字串解析問題。建議結合 man 3 regex、man 7 regex 閱讀完整手冊,並實作一個通用的「正則擷取工具函數」加入個人工具箱。