Python 網頁爬蟲基礎工具組:requests 處理 HTTP 請求,BeautifulSoup 解析 HTML。本文實作從 ITTF 國際桌總網站批量抓取選手詳細頁面連結的完整流程。
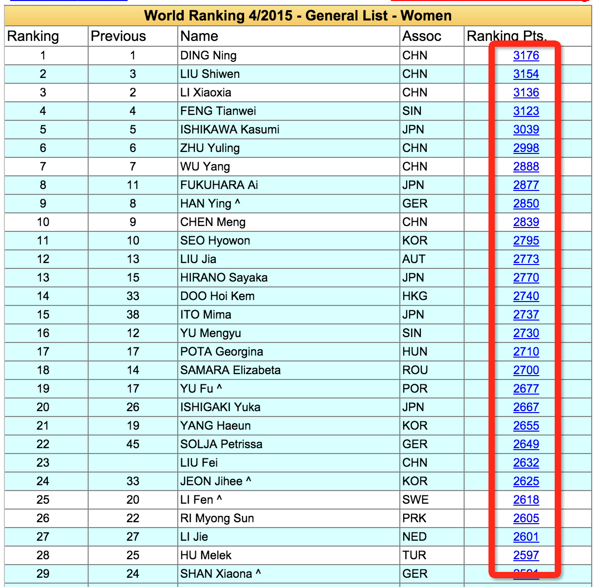
ITTF 世界排名頁面中所有選手的詳細資料超連結。
import requests
from bs4 import BeautifulSoup

url = ('https://www.ittf.com/ittf_ranking/WR_Table_3_A2.asp'
       '?Age_category_1=&Age_category_2=&Age_category_3='
       '&Age_category_4=&Age_category_5=&Category=100W'
       '&Cont=&Country=&Gender=W&Month1=4&Year1=2015'
       '&s_Player_Name=&Formv_WR_Table_3_Page=%d')

rank_link_pre = 'https://www.ittf.com/ittf_ranking/'
links = []

for page in range(1, 6):  # 假設 5 頁
    resp = requests.get(url % page)
    resp.encoding = 'utf-8'  # 明確指定編碼
    soup = BeautifulSoup(resp.text, 'html.parser')

    atags = soup.find_all('a')
    for atag in atags:
        href = atag.get('href')
        if href and "WR_Table_3_A2_Details.asp" in href:
            link = rank_link_pre + href
            links.append(link)
            print 'fetch link:', link

# 儲存至檔案
with open('links.txt', 'w') as f:
    for link in links:
        f.write(link + '\n')
| 工具 | 用法 |
|---|---|
requests.get() | 自動處理重導向、編碼偵測、連線池 |
resp.text | 自動解碼後的字串(內建 chardet) |
BeautifulSoup(resp.text, 'html.parser') | 標準庫解析器,無需外部依賴 |
soup.find_all('a') | 找出所有錨點標籤 |
atag.get('href') | 安全取得屬性,不存在回傳 None |
| 字串篩選 | "WR_Table_3_A2_Details.asp" in href |
headers={'User-Agent':...}、time.sleep()、Proxy 輪換selenium / playwright 驅動真實瀏覽器aiohttp + asyncio 並發請求robots.txt 與網站服務條款