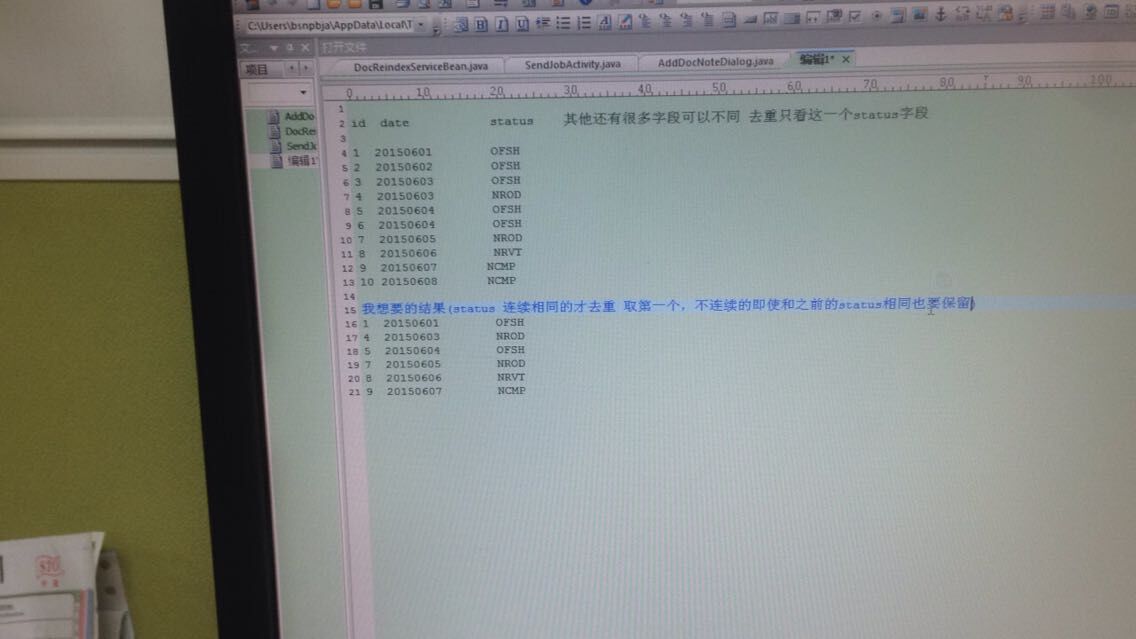
在 SQL Server 資料庫中,常遇到需刪除「連續重複」記錄的需求。例如:某欄位 status 若與上一筆資料相同,則視為重複;但若中間夾雜不同值,則不視為重複。這類「連續去重」無法用單純 DISTINCT 或 GROUP BY 解決。
核心技巧是「序號差分」:先按 status 排序產生序號 rn1,再按原始順序產生序號 rn2,兩者相減得到 rn_diff。連續相同 status 的記錄,其 rn_diff 值相同,即可作為分組鍵。
SELECT ROW_NUMBER() OVER (ORDER BY status) AS rn1 FROM table_nameSELECT ROW_NUMBER() OVER (ORDER BY id) AS rn2 FROM table_nameSELECT * FROM (SELECT *, ROW_NUMBER() OVER (PARTITION BY rn_diff ORDER BY id) AS rn3 FROM cte) t WHERE rn3 = 1WITH cte AS (
SELECT
id,
status,
ROW_NUMBER() OVER (ORDER BY status) AS rn1,
ROW_NUMBER() OVER (ORDER BY id) AS rn2
FROM your_table
),
grp AS (
SELECT
id,
status,
rn1 - rn2 AS rn_diff
FROM cte
)
DELETE FROM your_table
WHERE id IN (
SELECT id FROM (
SELECT
id,
ROW_NUMBER() OVER (PARTITION BY rn_diff ORDER BY id) AS rn3
FROM grp
) t
WHERE rn3 > 1
);