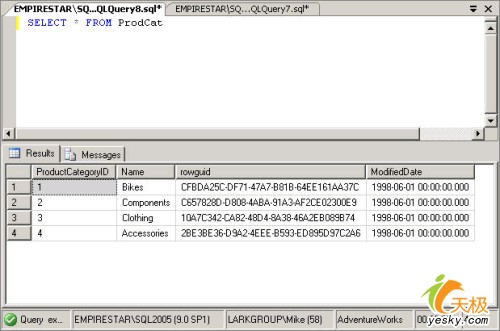
sqljdbc.jar) 讀 ntext 正常。sun.jdbc.odbc.JdbcOdbcDriver) 讀 ntext 出現亂碼。getObject() 讀 uniqueidentifier, text, nchar 回傳 null,僅 getString() 正常。ntext 為 Unicode 大物件 (最高 2GB),SQL Server 內部以 UTF-16 Little Endian 儲存。JDBC-ODBC Bridge 未正確處理碼頁轉換,導致位元組序誤讀。
byte[] bytes = rs.getBytes(colIndex);
String val = new String(bytes, "UTF-16LE");UTF-16LE 可還原純中文。getString() 並配合 ODBC DSN 設定 「將字元資料轉譯為 Unicode」 選項。ntext、nvarchar(max)。Apache POI、Jackcess、OpenCSV 等純 Java 函式庫,避免 ODBC 相依。| 場景 | 建議方案 |
|---|---|
| SQL Server 2005+ | Microsoft JDBC Driver 4.0+ / jTDS 1.3+ |
| SQL Server 2000 | Microsoft JDBC Driver 3.0 (舊包 msbase/mssqlserver/msutil) |
| 異構資料來源 | 專用純 Java Library (POI, Jackcess, OpenCSV...) |
| 舊系統必須用 ODBC | DSN 勾選 Unicode 選項 + 程式碼統一用 getString() |