面對龐大資料量時,單一資料表的索引深度與 I/O 瓶頸往往成為查詢效能的殺手。SQL Server 資料表分區 能將資料水平切分至多個檔案群組,甚至分散到不同實體磁碟,從而降低 B 樹層級、平行化 I/O、大幅提升查詢與維護效能。本文梳理完整建立流程、核心架構優勢與實戰注意點。
RANGE LEFT/RIGHT FOR VALUES)。CREATE TABLE 中指定 ON [分區配置名](分區欄位),完成分區表建立。完整範例程式碼可參考:Jacky Rong 的部落格實作。
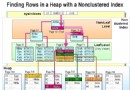
傳統單表隨資料增長,索引 B 樹根節點下層級遞增,導致 SEEK 操作遍歷層數增加、查詢變慢。分區將資料與索引頁分散至不同區、不同檔案群組,形成多棵較淺的 B 樹,大幅降低樹高。若再將檔案群組放置於不同實體磁碟,可並行 I/O,進一步加速大數據量篩選與掃描。
現有資料表轉分區需謹慎規劃,常見路徑:
SWITCH PARTITION 或 INSERT SELECT) → 重建索引/約束 → 切換同義詞或重命名表。資料表分區是大型資料庫架構師的必備技能。掌握「檔案群組 → 分區函數 → 分區配置 → 分區表」四步驟,理解其如何透過降低 B 樹深度與分散 I/O 來提升效能,能幫助你設計出可擴展、高效能的資料存儲方案。