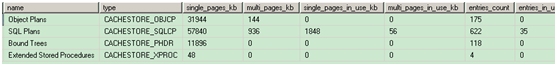
在應用程式開發中,最常見且隱蔽的效能殺手之一,便是使用非參數化的臨時查詢,而非預備陳述式或預存程序。這類寫法會導致 SQL Server 計畫快取中堆積大量無法重用的執行計畫,嚴重消耗記憶體資源並增加 CPU 壓力。
計畫快取是 SQL Server 共用記憶體池的一部分,用於儲存經過解析、編譯與優化後的查詢執行計畫。當查詢執行時,引擎會優先在快取中尋找可重用的計畫。若能重用,便能省去重複的解析、編譯與優化過程,顯著降低 CPU 負載並加快回應速度。
以下 Java 程式碼片段示範了一種典型的反模式:在迴圈中對 AdventureWorks 資料庫發送 20 個非參數化的臨時查詢,僅 WHERE 條件中的值不同。
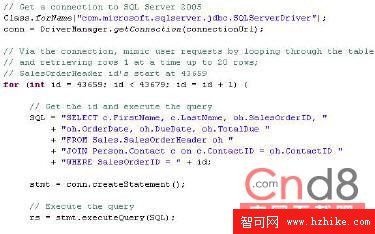
圖一:非參數化查詢的 Java 程式碼範例
執行後透過 DMV 查詢計畫快取:
SELECT qs.usecounts, cacheobjtype, objtype, qt.text
FROM sys.dm_exec_cached_plans qs
CROSS APPLY sys.dm_exec_sql_text(qs.plan_handle) AS qt
ORDER BY qt.text;
結果顯示,每次查詢都產生一個獨立、非參數化的計畫,use counts 均為 1,完全無法重用(圖二)。若此為高頻應用,記憶體將迅速耗盡。
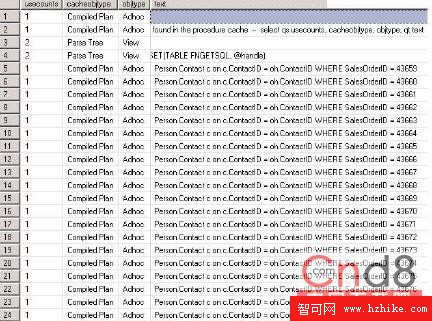
圖二:計畫快取中堆積的不可重用臨時計畫
將程式碼改為使用 PreparedStatement,並在執行前以 DBCC FREEPROCCACHE 清空快取:
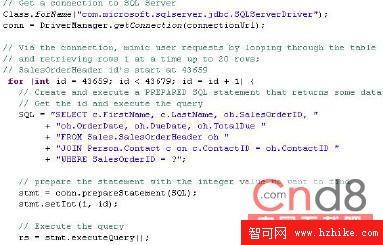
圖三:參數化查詢的 Java 程式碼範例
再次檢視快取,同一參數化計畫的 use counts 已達 20,完美重用,記憶體佔用極小,CPU 開銷大幅降低(圖四)。
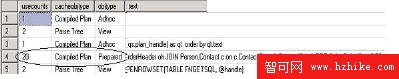
圖四:參數化查詢實現計畫重用
計畫快取屬於共用記憶體池,減少多餘計畫能騰出空間給資料快取,提升整體 I/O 效能。雖然參數化查詢已大幅改善,但筆者更推薦使用預存程序:
無論採用何種資料存取方式,核心原則只有一個:確保查詢計畫可重用,從根源上解決記憶體與 CPU 的潛在瓶頸。