前言
索引是關聯式資料庫效能調校的核心機制。本文系統解析 SQL Server 索引的內部架構(B+ 樹)、叢集與非叢集索引的本質差異、建立語法選項、填充因子策略,以及碎片整理與統計資料更新的維護實務,協助 DBA 與開發人員建立高效能的索引策略。
一、索引核心架構與類型
1. 叢集索引
- 定義:資料列依索引鍵值在表內實際排序儲存,葉層即為資料頁本身。
- 特性:每張表僅能有一個叢集索引(因資料只能依一種順序物理排序)。
- 適用場景:範圍查詢(BETWEEN、>、<)、頻繁排序欄位、外鍵參考欄位、身分識別欄位 (IDENTITY)。
- 優勢:掃描範圍時物理鄰近,減少 I/O;避免額外書籤查找。
2. 非叢集索引
- 定義:獨立於資料列的 B+ 樹結構,葉層包含索引鍵值與行定位器。
- 行定位器:
| 資料表類型 | 行定位器內容 |
|---|
| 堆積 (Heap,無叢集索引) | RID (File:Page:Slot 物理位址) |
| 叢集索引表 | 叢集索引鍵值 |
- 特性:可建立多個(SQL 2008+ 上限 999),資料列物理順序不變。
- 適用場景:精確查找 (=)、JOIN 條件欄位、WHERE 篩選欄位、覆蓋索引 (INCLUDE 欄位)。
3. 特殊索引類型
| 類型 | 特性 | 建立方式 |
|---|
| 唯一索引 | 強制鍵值唯一,兼具索引與約束功能 | CREATE UNIQUE INDEX / UNIQUE CONSTRAINT |
| 複合/組合索引 | 多欄位組合,順序決定搜尋效率(最左前綴原則) | CREATE INDEX idx ON tbl (col1, col2, col3) |
| 包含欄位索引 | 非鍵欄位僅存葉層,不參與排序,突破 900 位元組鍵長限制 | CREATE INDEX idx ON tbl (key_col) INCLUDE (col_a, col_b) |
| 篩選索引 | 僅索引符合 WHERE 條件的列,縮小體積 | CREATE INDEX idx ON tbl (col) WHERE status = 1 |
二、索引建立語法與選項
1. CREATE INDEX 完整語法
CREATE [UNIQUE] [CLUSTERED | NONCLUSTERED] INDEX index_name
ON table_name (column_name [ASC | DESC] [, ...])
[INCLUDE (column_name [, ...])]
[WHERE filter_predicate]
[WITH (
    FILLFACTOR = percent,
    PAD_INDEX = ON | OFF,
    SORT_IN_TEMPDB = ON | OFF,
    IGNORE_DUP_KEY = ON | OFF,
    STATISTICS_NORECOMPUTE = ON | OFF,
    ONLINE = ON | OFF,          -- Enterprise 版
    DATA_COMPRESSION = NONE | ROW | PAGE
)]
[ON filegroup_name | partition_scheme_name (column_name)];
2. CREATE TABLE 內建約束建立索引
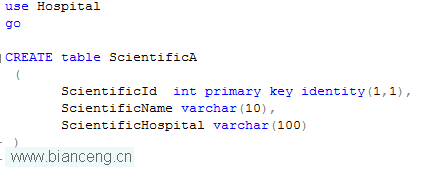
CREATE TABLE dbo.Orders (
    OrderID INT IDENTITY PRIMARY KEY CLUSTERED,  -- 叢集主鍵
    CustomerID INT NOT NULL,
    OrderDate DATETIME NOT NULL,
    CONSTRAINT UQ_Cust_Date UNIQUE NONCLUSTERED (CustomerID, OrderDate)
);
3. 關鍵選項深度解析
- FILLFACTOR (填充因子):指定葉層頁面填滿百分比 (0-100),預留空間減少分頁分裂。
經驗值:唯讀/極少修改表 100;高頻 INSERT/UPDATE 表 70-80。
- PAD_INDEX:將 FILLFACTOR 套用至中繼層頁面。
- ONLINE = ON:線上建立/重建,不鎖定資料表(Enterprise 版專屬)。
- DATA_COMPRESSION:頁面/列壓縮,降低 I/O 與記憶體壓力,CPU 微增。
三、索引維護與碎片管理
1. 碎片類型與檢測
- 邏輯碎片:葉層頁面邏輯順序與物理順序不一致,導致讀取跳躍。
- 頁面密度:頁面填滿度過低,浪費空間並增加讀取頁數。
- 檢測指令:
DBCC SHOWCONTIG (舊版) 或 sys.dm_db_index_physical_stats (2005+)。
2. 維護指令對比
| 指令 | 適用版本 | 操作 | 鎖定行為 | 線上支援 | 統計資料更新 |
|---|
| DBCC DBREINDEX | 2000/2005 | 重建單一/所有索引 | Schema-Modify (Sch-M) 獨佔鎖 | 否 | 是 (FULLSCAN) |
| DBCC INDEXDEFRAG | 2000/2005 | 線上整理葉層碎片 | 共享鎖,可中斷 | 是 | 否 |
| ALTER INDEX REBUILD | 2005+ | 重建索引 (可指定分區) | Sch-M (ONLINE=OFF) / 意圖鎖 (ONLINE=ON) | Enterprise 版 ONLINE=ON | 是 |
| ALTER INDEX REORGANIZE | 2005+ | 線上整理葉層 | 共享鎖,可中斷 | 是 | 否 |
3. 維護策略建議
- 碎片率 > 30% →
REBUILD (離線或線上)。
- 碎片率 5%-30% →
REORGANIZE。
- 碎片率 < 5% → 無需處理。
- 搭配
UPDATE STATISTICS 或 sp_updatestats 同步更新統計資料。
- 建立 SQL Agent 定期維護計畫(每週/每日視業務量),並記錄維護歷程。
四、索引設計黃金法則
- 窄而精:索引鍵越窄,樹高越矮,單頁容納更多鍵值,I/O 越少。
- 高選擇性優先:唯一值比例高的欄位放在複合索引最左側。
- 覆蓋查詢:使用 INCLUDE 欄位滿足 SELECT 清單,避免書籤查找。
- 避免過度索引:OLTP 表建議 ≤ 5-6 個索引;每新增索引增加 INSERT/UPDATE/DELETE 開銷。
- 外鍵必索引:所有 FK 欄位建立非叢集索引,加速 JOIN 與刪除父列時的子表掃描。
- 叢集索引選擇:優先考慮單調遞增 (IDENTITY)、窄、唯一、常用於範圍查詢的欄位。
總結
索引是把雙面刃:設計得當可將查詢提升數量級,濫用則拖垮寫入效能。掌握 B+ 樹原理、叢集與非叢集本質差異、填充因子與碎片整理機制,並建立定期維護與監控機制,才能讓索引持續發揮最大效益。隨著 SQL Server 版本演進,線上操作、壓縮、篩選索引、欄存索引等新特性更為大數據場景提供強大支援。