邏輯主鍵(如 LastName + FirstName)重複,但物理主鍵(ID)不同。範例表 Customers 含 3 組冗資料,共 10 列重複。
DELETE FROM Customers
WHERE ID NOT IN (SELECT MIN(ID) FROM Customers GROUP BY LastName, FirstName);
缺點:需兩次全表掃描,大表極慢(500 萬列測試 1 小時未完成),且無法控制保留哪一列(只能保留最小 ID)。
CREATE OR REPLACE PROCEDURE DeleteDuplicates (pCommitBatchSize IN INTEGER := 5000) IS
    CURSOR csr_Dup IS
        SELECT ID, LastName, FirstName
        FROM Customers
        WHERE (LastName, FirstName) IN (
            SELECT LastName, FirstName FROM Customers
            GROUP BY LastName, FirstName HAVING COUNT(*) > 1
        )
        ORDER BY LastName, FirstName;

    vLastName Customers.LastName%TYPE := NULL;
    vFirstName Customers.FirstName%TYPE := NULL;
    vCounter INTEGER := 0;
BEGIN
    FOR rec IN csr_Dup LOOP
        IF vLastName IS NULL OR rec.LastName != vLastName OR NVL(rec.FirstName,' ') != NVL(vFirstName,' ') THEN
            vLastName := rec.LastName; vFirstName := rec.FirstName;  -- 首列保留
        ELSE
            DELETE FROM Customers WHERE ID = rec.ID;  -- 後續重複刪除
            vCounter := vCounter + 1;
            IF MOD(vCounter, pCommitBatchSize) = 0 THEN COMMIT; END IF;
        END IF;
    END LOOP;
    IF vCounter > 0 THEN COMMIT; END IF;
    DBMS_OUTPUT.PUT_LINE(vCounter || ' duplicates deleted.');
EXCEPTION WHEN OTHERS THEN
    DBMS_OUTPUT.PUT_LINE('Error ' || SQLCODE || ': ' || SQLERRM);
    ROLLBACK;
END;
/
測試 500 萬列:56 秒。可控制保留首列,但需編寫程序、維護成本高。
DELETE FROM Customers
WHERE ID IN (
    SELECT ID FROM (
        SELECT ID,
               RANK() OVER (PARTITION BY LastName, FirstName ORDER BY ID) AS rn
        FROM Customers
    ) WHERE rn > 1
);
DELETE FROM Customers
WHERE ID IN (
    SELECT ID FROM (
        SELECT ID,
               RANK() OVER (PARTITION BY LastName, FirstName ORDER BY ID) AS rn
        FROM Customers
        WHERE (LastName, FirstName) IN (
            SELECT LastName, FirstName FROM Customers
            GROUP BY LastName, FirstName HAVING COUNT(*) > 1
        )
    ) WHERE rn > 1
);
測試結果:
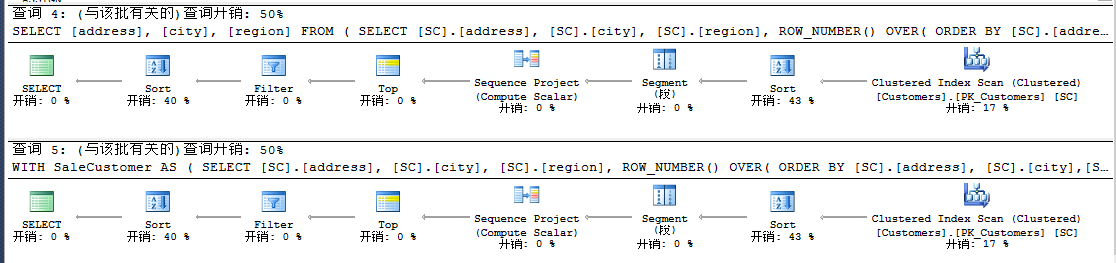
基礎版 135 秒 → 優化版 47 秒(提升 65%),優於 PL/SQL 56 秒。
ORDER BY RecDate DESC, IDHAVING COUNT(*) > 3 搭配 WHERE rn > 3| 方法 | 適用場景 | 效能 | 保留策略靈活度 | 維護性 |
|---|---|---|---|---|
| MIN(ID) 子查詢 | 小表、一次性清理 | 差 | 固定(最小 ID) | 高(單一 SQL) |
| PL/SQL 遊標 | 需複雜邏輯、舊版無分析函數 | 中 | 高(程式控制) | 低(需部署程序) |
| RANK() 完整掃描 | 中型表、單一保留規則 | 中 | 高(ORDER BY 任意) | 高 |
| RANK() + 預過濾 | 大表、生產環境常態化 | 最佳 | 最高 | 高 |
結論:現代 Oracle/SQL Server/PostgreSQL 皆支援 RANK(),請優先採用「預過濾重複群組 + RANK()」單一 SQL 方案,兼顧效能、靈活度與可維護性。