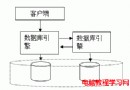
資料表的資料列實際按索引鍵值排序儲存,就像字典正文按拼音排序。每張表只能有一個聚集索引。
索引與資料分離,像字典的部首檢字表,需先查目錄取得頁碼,再翻至正文。可建立多個非聚集索引。
| 動作描述 | 聚集索引 | 非聚集索引 |
|---|---|---|
| 欄位常被分群排序 | ✓ | ✓ |
| 回傳某範圍內資料 | ✓ | ✗ |
| 極少不同值 | ✗ | ✗ |
| 少量不同值 | ✓ | ✗ |
| 大量不同值 | ✗ | ✓ |
| 頻繁更新的欄位 | ✗ | ✓ |
| 外鍵欄位 | ✓ | ✓ |
| 主鍵欄位 | ✓ | ✓ |
| 頻繁修改索引欄位 | ✗ | ✓ |
預設主鍵建立聚集索引,但若主鍵為自增 ID,查詢條件多為日期/用戶,導致全表掃描。實測 1000 萬筆資料,查詢近 3 個月(25 萬筆):
結論:聚集索引應建在最常用的篩選/排序欄位,而非盲目給主鍵。
同一欄位,非聚集 vs 聚集索引效能差異巨大(上例 54 秒 vs 2 秒)。關鍵在於「適當」的索引類型。
複合索引前導欄位必須是最常用查詢欄位。實測:
SQL Server 查詢優化器會自動重排 WHERE 條件順序,但需符合 SARG(Search Argument)形式:
欄位 運算子 <常數/變數>
-- 例:Price > 5000、Name = '張三' AND Price > 5000
不符合 SARG 的情況:
LIKE '%關鍵字' 開頭萬用字元OR 條件導致全表掃描NOT、!=、<>、函數運算(如 ABS(Price) < 5000)IN 等同 OR,會使索引失效EXISTS vs IN 效能相同(含 NOT 時)CHARINDEX vs LIKE '%...%' 效能相同UNION 通常優於 OR,但若條件欄位相同則 OR 更快SELECT *,依需求取欄位,速度顯著提升COUNT(*) 不比 COUNT(主鍵) 慢,反而比其他欄位快ORDER BY 聚集索引欄位效能最高,正序/倒序無差異TOP 限制輸出行數,減少 I/O 開銷SELECT TOP @PageSize *
FROM Table1
WHERE ID > (
SELECT MAX(ID) FROM (
SELECT TOP ((@PageIndex-1)*@PageSize) ID FROM Table1 ORDER BY ID
) AS T
)
ORDER BY ID實測 1000 萬筆資料,方案 3 在 50 萬頁仍只需 7 秒,遠優於前兩者。
pagination3支援:動態表名、欄位、排序、條件、頁碼/頁大小、總筆數統計、升/降序切換。大資料量查詢末頁仍在 9 秒內。
聚集索引極其珍貴(每表僅一個),必須同時滿足:
若篩選欄位(如日期)有重複值無法用於分頁定位,建議新增高精度時間欄位(毫秒級 + UNIQUE 約束)作為聚集索引,兼顧篩選與分頁。
本文彙整實戰經驗,強調「軟優化」(索引、查詢寫法、分頁演算法)與「硬資源」(CPU、記憶體、網路)並重。實測發現大量查詢下 CPU 為主要瓶頸而非記憶體。持續測試、分析執行計畫,才能找出最優方案。