面對 GB 級的 SQL Profiler Trace 檔案,手工分析或直接載入資料表查詢極其低效。本文介紹微軟官方免費工具 Read80Trace (RML Utilities) 搭配自訂存儲程序 usp_GetAccessPattern,實現語句標準化分組、多維度資源消耗排名、訪問模式全景掌握,讓效能調優從「大海撈針」變為「提綱挈領」。
WHERE id = 1 / id = 2) 顯示為不同行,無法見到該類查詢的整體影響。核心功能: 讀取 .trc 檔案 → 語句標準化 (移除字面值參數) → 匯入資料庫產生分析表 → 生成 HTML 報告 / RML 回放檔。
-- 原始 Trace 片段
SELECT * FROM authors WHERE au_lname = 'white'
SELECT * FROM authors WHERE au_lname = 'green'
SELECT * FROM authors WHERE au_lname = 'carson'

-- 標準化後 (NormText)
SELECT * FROM authors WHERE au_lname = @p1
SELECT * FROM authors WHERE au_lname = @p1
SELECT * FROM authors WHERE au_lname = @p1
三條語句歸為同一 HashId,後續聚合統計即可得到該查詢模式的總體資源消耗。
Read80Trace -f -d MyAnalysisDB -I MyTrace.trc-f:不產生 RML 回放檔 (節省空間,若無回放需求請加上)。-d:指定目標資料庫,工具會自動建立 tblBatches、tblUniqueBatches 等分析表。-I:輸入 Trace 檔案 (支援多檔案自動遞歸讀取 mytrace.trc, mytrace1.trc...)。部署於 Read80Trace 產生的資料庫 (如 MyAnalysisDB) 中,核心邏輯:
NormText (標準化語句) GROUP BY,求各類查詢的 SUM/AVG。@duration_filter 參數 (毫秒),僅統計執行時間超過閾值的語句,交叉驗證高頻 vs 高耗。CREATE PROCEDURE usp_GetAccessPattern
@duration_filter INT = -1 -- 毫秒,-1 表示不篩選
AS
BEGIN
SET NOCOUNT ON;
DECLARE @sum_total FLOAT, @sum_cpu FLOAT, @sum_reads FLOAT, @sum_duration FLOAT, @sum_writes FLOAT;
-- 1. 總資源基線
SELECT
@sum_total = COUNT(*) * 0.01,
@sum_cpu = SUM(cpu) * 0.01,
@sum_reads = SUM(reads) * 0.01,
@sum_writes = SUM(writes) * 0.01,
@sum_duration = SUM(duration) * 0.01
FROM tblBatches
WHERE duration >= @duration_filter;
-- 2. 按標準化語句聚合
SELECT
LTRIM(STR(COUNT(*))) AS exec_stats,
STR(COUNT(*)/@sum_total, 4, 1) + '%' AS ExecRatio,
LTRIM(STR(SUM(cpu))) + ' : ' + LTRIM(STR(AVG(cpu))) AS cpu_stats,
STR(SUM(cpu)/@sum_cpu, 4, 1) + '%' AS CpuRatio,
LTRIM(STR(SUM(reads))) + ' : ' + LTRIM(STR(AVG(reads))) AS reads_stats,
STR(SUM(reads)/@sum_reads, 4, 1) + '%' AS ReadsRatio,
LTRIM(STR(SUM(duration))) + ' : ' + LTRIM(STR(AVG(duration))) AS duration_stats,
STR(SUM(duration)/@sum_duration, 4, 1) + '%' AS DurRatio,
textdata,
COUNT(*)/@sum_total AS tp,
SUM(cpu)/@sum_cpu AS cp,
SUM(reads)/@sum_reads AS rp,
SUM(duration)/@sum_duration AS dp
INTO #Query_Statistics
FROM (
SELECT
b.reads, b.cpu, b.duration, b.writes,
CONVERT(VARCHAR(2000), u.NormText) AS textdata
FROM tblBatches b
INNER JOIN tblUniqueBatches u ON b.HashId = u.HashId
WHERE b.duration > @duration_filter
) B
GROUP BY textdata;
-- 3. 五大維度 Top 10 輸出
PRINT 'Top 10 by CPU+Reads+Duration'; SELECT TOP 10 * FROM #Query_Statistics ORDER BY cp+rp+dp DESC;
PRINT 'Top 10 by CPU'; SELECT TOP 10 * FROM #Query_Statistics ORDER BY cp DESC;
PRINT 'Top 10 by Reads'; SELECT TOP 10 * FROM #Query_Statistics ORDER BY rp DESC;
PRINT 'Top 10 by Duration'; SELECT TOP 10 * FROM #Query_Statistics ORDER BY dp DESC;
PRINT 'Top 10 by Execution Count'; SELECT TOP 10 * FROM #Query_Statistics ORDER BY tp DESC;
END;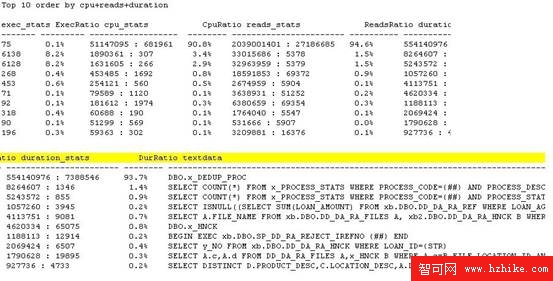
DBO.x_DEDUP_PROC 2 小時執行 75 次,佔 90.8% CPU、94.6% Reads。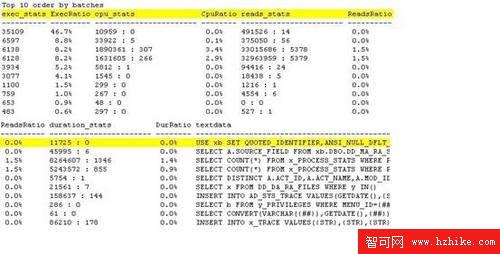
SET QUOTED_IDENTIFIER... (無優化價值)。SELECT COUNT(*) FROM x_PROCESS_STATS... (佔 8.2%),但 CPU/Reads 佔比極低,可暫緩處理。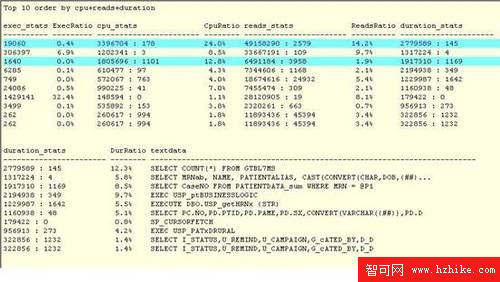
SELECT COUNT(*) FROM GTBL7MS、SELECT CaseNO FROM PATIENTDATA_sum WHERE MRN = @P1。@duration_filter = -1, 1000, 3000, 5000,在多份報表中重複出現的語句 = 必須優化的核心目標。tblBatches.reads/cpu/writes 為 INT,大量 Trace 易溢位。執行:
ALTER TABLE tblBatches ALTER COLUMN reads BIGINT;
ALTER TABLE tblBatches ALTER COLUMN cpu BIGINT;
ALTER TABLE tblBatches ALTER COLUMN writes BIGINT;-- 按 DBID 聚合資源消耗
SELECT
dbid,
STR(COUNT(*)/@sum_total, 4, 1) + '%' AS ExecRatio,
STR(SUM(cpu)/@sum_cpu, 4, 1) + '%' AS CpuRatio,
STR(SUM(reads)/@sum_reads, 4, 1) + '%' AS ReadsRatio,
STR(SUM(duration)/@sum_duration, 4, 1) + '%' AS DurRatio
FROM (
SELECT b.dbid, b.cpu, b.reads, b.duration
FROM tblBatches b
INNER JOIN tblUniqueBatches u ON b.HashId = u.HashId
) B
GROUP BY dbid
ORDER BY SUM(reads) DESC;輸出範例:DBID 37、33、36 為前三大資源消費庫;DBID 20 語句最多 (53.9%) 但資源佔比低 → 可能為高頻輕量查詢 (如心跳、配置讀取)。
Read80Trace + usp_GetAccessPattern 代表了「離線深度分析」流派的巔峰。掌握這套方法論——標準化 → 聚合 → 百分比排名 → 交叉驗證——即使工具更迭,分析思維依然通用,助你在任何 Trace/Event/Query Store 數據面前,快速鎖定那 20% 引發 80% 問題的查詢模式。