DISTINCT 關鍵字用於過濾重複行,返回唯一不同的值組合。關鍵限制:只能返回 SELECT 清單中指定的欄位,無法直接搭配其他非去重欄位輸出。
假設表 A 資料如下:
| id | name |
|---|---|
| 1 | 張三 |
| 2 | 李四 |
| 3 | 張三 |
| 4 | 王五 |
SELECT DISTINCT name FROM A;
結果:張三、李四、王五(3 筆)

SELECT DISTINCT name, id FROM A;
實際依據 name+id 組合 去重。因 id 為主鍵不重複,結果仍為 4 筆。
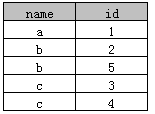
支援度:Access 與 SQL Server 均支援。
-- SQL Server 支援
SELECT COUNT(DISTINCT name) FROM A;        -- 結果:3

-- SQL Server 不支援
SELECT COUNT(DISTINCT name, id) FROM A;    -- 語法錯誤

-- Access 兩者均不支援
-- 錯誤:DISTINCT 必須緊接 SELECT 之後
SELECT id, DISTINCT name FROM A;  -- 語法錯誤
錯誤想法:SELECT DISTINCT name, remark FROM A 期望 name 去重且保留對應 remark
現實:實際是 (name, remark) 組合去重,無法達成「name 去重 + 任意對應 remark」的需求。
ROW_NUMBER() OVER (PARTITION BY name ORDER BY id) 取第一行GROUP BY name 搭配 ANY_VALUE(remark)(需關閉 ONLY_FULL_GROUP_BY)DISTINCT 會觸發昂貴的排序/雜湊去重操作GROUP BY、EXISTS、視窗函數往往效能更優