SQL Server 2014 引入 **In-Memory OLTP (Hekaton)**,針對高並發、低延遲場景設計。記憶體優化表支援兩類索引:
建表時指定 BUCKET_COUNT:
CREATE TABLE dbo.HK_tbl (
    ID INT IDENTITY(1,1) NOT NULL PRIMARY KEY NONCLUSTERED HASH WITH (BUCKET_COUNT = 100000),
    Data CHAR(32) COLLATE Latin1_General_100_BIN2 NULL,
    dt DATETIME NOT NULL
) WITH (MEMORY_OPTIMIZED = ON, DURABILITY = SCHEMA_AND_DATA);
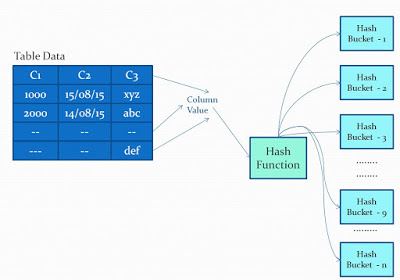
Bucket_ID = Hash_Value % BUCKET_COUNT (實際為位運算優化)。ALTER TABLE ... REBUILD WITH (BUCKET_COUNT = ...) 離線重建**。同一 Bucket 內多個不同鍵值 → 形成**單向鏈表**。查找流程:
| 特性 | 2014 | 2016+ |
|---|---|---|
| 建表後修改 Bucket Count | 不支援 (需重建表) | 支援 ALTER TABLE ... REBUILD WITH (BUCKET_COUNT = ...) (離線) |
| 新增/刪除哈希索引 | 不支援 | 支援 ALTER TABLE ADD/DROP INDEX ... HASH ... (離線) |
| JSON/時間序列支援 | 無 | 原生優化 |
WHERE ID = @val、JOIN ON T1.ID = T2.ID → **首選哈希索引**。WHERE Date BETWEEN ...、ORDER BY Date → **必須範圍索引**。-- 查看哈希索引 Bucket 使用情況 (衝突統計)
SELECT
object_name(object_id) AS TableName,
name AS IndexName,
total_bucket_count,
empty_bucket_count,
avg_chain_length,
max_chain_length,
CAST(1.0 * total_bucket_count / NULLIF(empty_bucket_count,0) AS DECIMAL(10,2)) AS LoadFactor
FROM sys.hash_indexes
WHERE object_id = OBJECT_ID('dbo.HK_tbl');
avg_chain_length > 1:有衝突,評估是否需增大 Bucket Count。max_chain_length > 10:嚴重衝突,**立即重建擴大 Bucket**。empty_bucket_count = 0:Bucket 已滿,必須擴容。| 維度 | SQL Server (Hekaton) | MySQL (InnoDB AHI) |
|---|---|---|
| 建立方式 | 顯式 DDL 定義 | 引擎自動監控熱頁面動態建立 |
| 控制粒度 | 表/索引級精確控制 | 全域開關 innodb_adaptive_hash_index |
| 持久化 | 記憶體優化表僅記憶體 (SCHEMA_AND_DATA 含持久化日誌) | 緩衝池頁面,重啟後重建 |
| 適用引擎 | 僅 Memory-Optimized Tables | 標準 InnoDB 表 |
SQL Server 2014+ 哈希索引是 **記憶體優化表點查詢的極致加速器**。核心在於 **Bucket Count 科學預估 (2^n, 1-2倍行數) 與持續監控鏈長**。2016 帶來的離線重建能力徹底解決了「建錯無法改」的痛點。**不適用範圍查詢/排序**,務必配合範圍索引混合部署。掌握「哈希定位 → 鏈表遍歷 → 版本可見性」三步查找鏈路,即可在 Hekaton 架構下榨乾記憶體級效能。