上篇比較 `SELECT COUNT(*)` 與 `SELECT *` 效能,讀者建議補測 `MAX(id)` 取得最大流水號。本文實測發現:相同資料表、不同欄位、不同資料型別下,`MAX()` 效能差異極大,揭示資料型別與索引特性對聚合函數效能的決定性影響。
測試環境
- 資料表 `T_BasicInformation`、`t_SellLogDetail` (含百萬筆測試資料)。
- 使用 `DATEDIFF(ms, @start, GETDATE())` 量測毫秒級耗時。
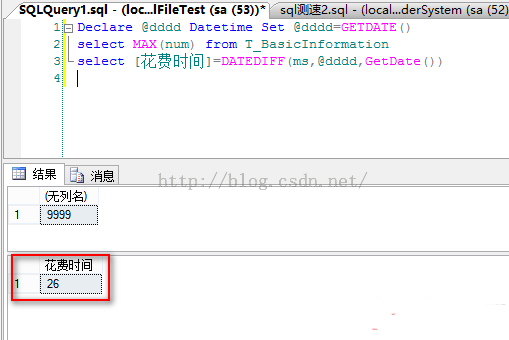
第一輪測試:T_BasicInformation 表
DECLARE @d DATETIME = GETDATE();
SELECT MAX(num) FROM T_BasicInformation;
SELECT DATEDIFF(ms, @d, GETDATE()) AS [耗時ms];
結果: ~20 ms (慢於預期的 `COUNT(*)` ~3 ms)。
第二輪測試:t_SellLogDetail 表 (同表不同欄位)
| 查詢 | 欄位定義 | 耗時 | 執行計畫特徵 |
|---|
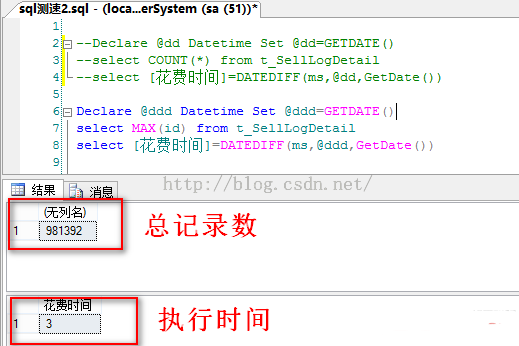
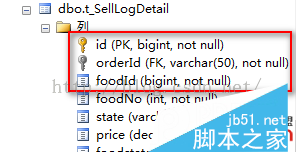
MAX(id) | PK, INT, IDENTITY | 0 ms | Stream Aggregate + Index Seek (極速) |
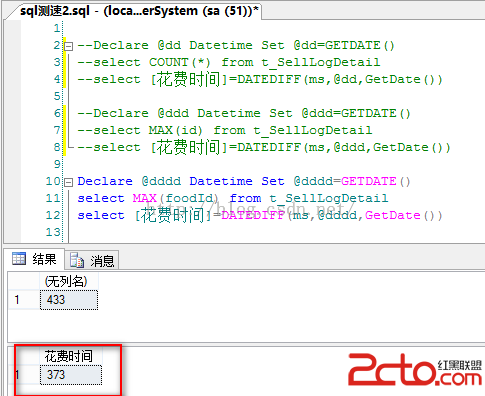
MAX(foodId) | INT, 非 PK, 有非叢集索引 | ~15 ms | Index Scan + Stream Aggregate |
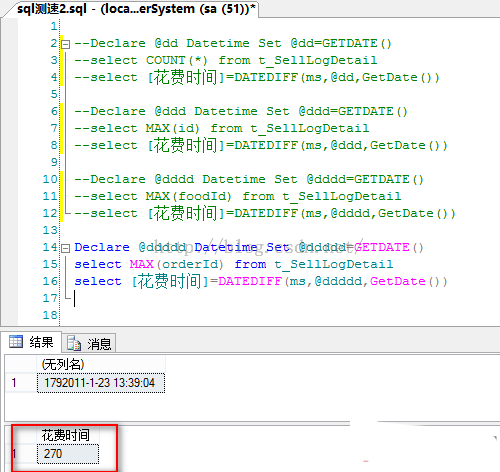
MAX(orderId) | VARCHAR(50), 無索引 | ~120 ms | Table Scan + Stream Aggregate |
核心發現
- 主鍵 + 整數型別 (INT/BIGINT) + IDENTITY:`MAX()` 極速 (0~1 ms),優化器直接讀取 B-tree 邊界頁。
- 非主鍵整數 + 有索引:需掃描索引葉層,耗時隨索引大小線性增長。
- 字串型別 (VARCHAR/NVARCHAR) 無索引:全表掃描,轉換比較開銷大,最慢。
- COUNT(*) vs MAX(PK):`COUNT(*)` 需掃描所有列 (或叢集索引葉層) 計數;`MAX(PK)` 僅讀取最右葉頁,**單筆流水號取得場景 `MAX(PK)` 完勝**。
實務建議
- 需取得「下一個流水號」:使用 `MAX(PK_IDENTITY)` + 1 (單用戶/低併發) 或 `SEQUENCE` / `IDENTITY` 機制 (高併發)。
- 統計總筆數:`COUNT(*)` 配合觸發器維護計數表、或 `sys.dm_db_partition_stats` 近似值 (大表)。
- 聚合查詢優化優先順序:建立適當索引 > 選擇高優先級資料型別 (INT > VARCHAR) > 改寫查詢。
- 測試必須在目標表、真實資料量、真實索引下進行,勿憑直覺或單一表測試推論全域。
效能優化無銀彈,唯有「理解引擎機制 + 實測驗證 + 持續觀測」才能做出正確選擇。