三者**語意相同、執行計畫相同、效能相同**。優化器會自動轉換為「計算非 NULL 資料列數」。
COUNT(expression) 會評估每列的 expression,**非 NULL 才計數**。
COUNT(*):* 代表整列,永不為 NULL → 計算總列數。COUNT(1):常數 1 永不為 NULL → 計算總列數。COUNT('abc'):常數字串永不為 NULL → 計算總列數。COUNT(column):該欄位為 NULL 的列**不計數** → 計算該欄位非 NULL 列數。DECLARE @x INT = NULL;
SELECT COUNT(@x) FROM Sales.SalesOrderHeader; -- 結果 0,因為 @x 永遠是 NULL以 AdventureWorks2012.Person.Address 為例:
SELECT COUNT(*) FROM Person.Address;
SELECT COUNT(1) FROM Person.Address;
SELECT COUNT(AddressID) FROM Person.Address;
→ 全部走 **Clustered Index Scan**,成本相同。
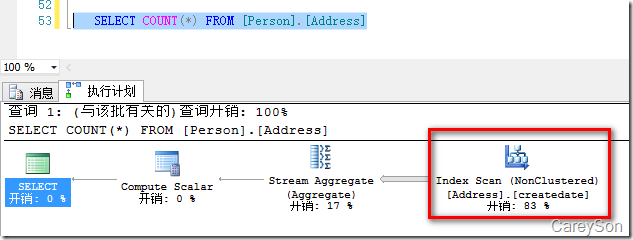
優化器選擇 **最窄的非叢集索引** (ModifyDate) 執行 Index Scan**,避免掃描寬的叢集索引。
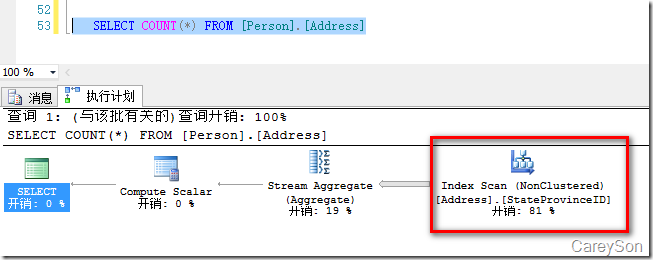
優化器改選 **更窄的 StateProvinceID 索引** (4 bytes < 8 bytes),I/O 更少。
若某資料表頻繁執行
COUNT(*),**在最窄的 NOT NULL 欄位上建立單欄非叢集索引**,可極大提升效能。
若欄位允許 NULL,優化器仍需評估每列是否為 NULL,無法單純掃描索引葉層計數 (除非加 WHERE col IS NOT NULL 或建立 篩選索引 WHERE col IS NOT NULL)。
-- 計算非 NULL 個數
SELECT COUNT(Color) FROM Production.Product; -- Color 有 NULL,結果 < 總列數

-- 計算 distinct 非 NULL 個數
SELECT COUNT(DISTINCT Color) FROM Production.Product;| 方法 | 優點 | 缺點 | 適用場景 |
|---|---|---|---|
sys.dm_db_partition_stats | 毫秒級、無鎖定、不掃描資料頁 | 近似值 (含未認可交易、延遲更新) | 儀表板、近似統計 |
sp_spaceused 'TableName' | 快速、含空間資訊 | 近似值 | DBA 快速查核 |
| 觸發器維護計數表 | 精確、即時 | 寫入開銷、複雜度高 | 極高頻精確計數需求 |
索引檢視表 COUNT_BIG(*) | 精確、查詢極快 | 維護成本、限制多 | 核心報表、資料倉儲 |
SELECT
    OBJECT_SCHEMA_NAME(p.object_id) AS SchemaName,
    OBJECT_NAME(p.object_id) AS TableName,
    SUM(p.rows) AS RowCount
FROM sys.partitions p
JOIN sys.objects o ON p.object_id = o.object_id
WHERE o.type = 'U' AND p.index_id IN (0,1) -- Heap 或 Clustered
GROUP BY p.object_id
ORDER BY RowCount DESC;SELECT
OBJECT_SCHEMA_NAME(object_id) AS SchemaName,
OBJECT_NAME(object_id) AS TableName,
SUM(row_count) AS ApproxRowCount
FROM sys.dm_db_partition_stats
WHERE index_id IN (0,1)
GROUP BY object_id
ORDER BY ApproxRowCount DESC;| 迷思 | 真相 |
|---|---|
| COUNT(1) 比 COUNT(*) 快,因為不取所有欄位 | 錯誤。優化器直接忽略投影列表,只算列數。 |
| COUNT(主鍵) 最快 | 不一定。最快的是**最窄的非叢集索引** (或篩選索引)。 |
| COUNT(*) 需要全表掃描 | 不一定。有合適窄索引時會走 Index Scan。 |
COUNT(*)、COUNT(1)、COUNT('x') **完全等價**,寫習慣的即可。COUNT(column) 計算**該欄位非 NULL 列數**,語意不同。sys.dm_db_partition_stats 或 sp_spaceused。