資料表與索引是關聯式資料庫最基礎的兩大物件。深入理解列/行/欄位/記錄的對應關係、索引 B+ 樹結構、叢集與非叢集索引的物理儲存差異,是效能調優與資料建模的內功基礎。
| 邏輯概念 | 物理實現 | 關鍵特性 |
|---|---|---|
| 資料表 | Heap (堆積) 或 叢集索引葉層 | 無序 (Heap) / 依叢集鍵有序 |
| 欄位 | 資料頁內固定/變動位移陣列 | 資料型別、長度、NULL 位圖、定序 |
| 列/記錄 | 資料列 (Data Row) - 8060 位元組上限 | 含資料、NULL 位圖、變長欄位位移陣列、版本標記 |
| 主鍵 | 唯一索引 (叢集/非叢集) + NOT NULL 約束 | 實體識別、參考完整性基礎 |
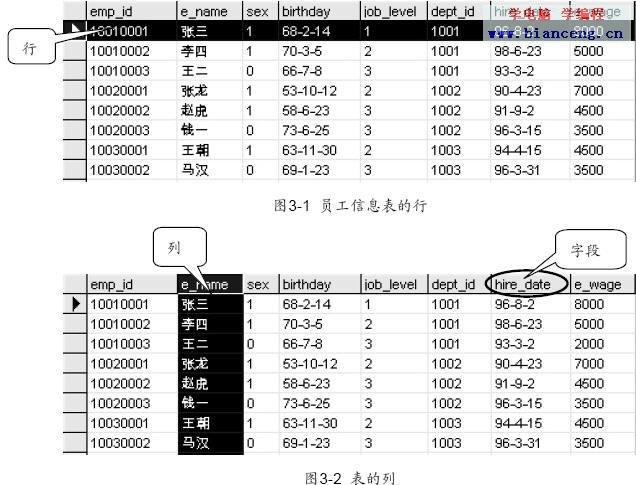
範例解讀:第一列資料表達 `EmpID=10010001, Name=張三, Gender=男, Birth=1968-02-14, Level=1, Dept=1001, HireDate=1996-08-02, Salary=8000`。
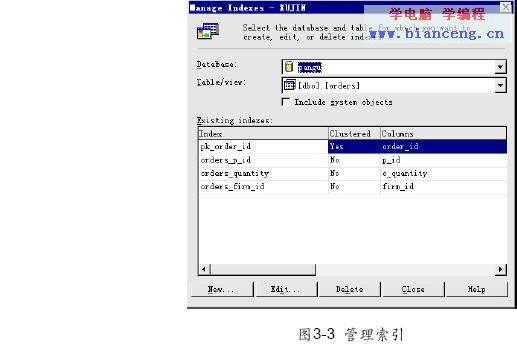
| 特性 | 叢集索引 | 非叢集索引 |
|---|---|---|
| 每表數量 | 最多 1 個 | 最多 999 個 (SQL 2008+) |
| 葉層內容 | 完整資料列 | 索引鍵值 + 列定位器 (RID/叢集鍵) |
| 資料順序 | 物理依索引鍵排序 | 邏輯依索引鍵排序,物理無序 |
| 查詢覆蓋 | 天然覆蓋所有欄位 | 需 INCLUDE 欄位或書籤查閱 |
| 插入/更新開銷 | 頁分裂風險、需維護順序 | 僅維護索引樹、開銷較小 |
| 建議鍵特性 | 窄、唯一、遞增、靜態 (如 IDENTITY) | 高選擇性、常用於 WHERE/JOIN/ORDER BY |
資料表定義「儲存什麼」,索引決定「怎麼快速找到」。將索引設計視為查詢調優的第一工序,而非事後補救,能從架構層面奠定高效能基礎。