處理「父子關係表」 (如組織架構、BOM、分類樹) 時,常需查詢指定節點的所有後代。除遞迴 CTE 外,佇列模擬 (WHILE 迴圈 + 暫存表) 在深層、大資料量下常有更好效能。本文示範佇列寫法並分析適用場景。
CREATE TABLE dbo.Hierarchy (
    NodeID INT PRIMARY KEY,
    NodeName NVARCHAR(50),
    ParentID INT NULL REFERENCES dbo.Hierarchy(NodeID)
);
-- 假設資料:NodeID=3 為根,擁有 9 個後代 (5~13)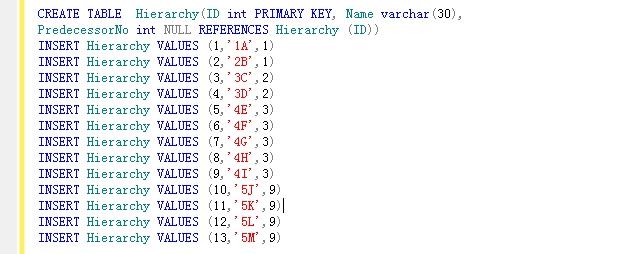
CREATE PROC dbo.usp_GetDescendants_Queue
    @RootID INT
AS
BEGIN
    SET NOCOUNT ON;

    -- 1. 結果暫存表
    CREATE TABLE #Descendants (NodeID INT PRIMARY KEY, NodeName NVARCHAR(50), Level INT);

    -- 2. 佇列暫存表 (模擬 BFS)
    CREATE TABLE #Queue (NodeID INT PRIMARY KEY, Level INT);

    -- 3. 初始化:放入根節點
    INSERT INTO #Queue (NodeID, Level)
    SELECT NodeID, 0 FROM dbo.Hierarchy WHERE NodeID = @RootID;

    INSERT INTO #Descendants (NodeID, NodeName, Level)
    SELECT NodeID, NodeName, 0 FROM dbo.Hierarchy WHERE NodeID = @RootID;

    -- 4. 迴圈展開
    DECLARE @CurrentLevel INT = 0;
    WHILE EXISTS (SELECT 1 FROM #Queue WHERE Level = @CurrentLevel)
    BEGIN
        -- 取出目前層級節點,尋找其直接子節點
        INSERT INTO #Descendants (NodeID, NodeName, Level)
        SELECT h.NodeID, h.NodeName, @CurrentLevel + 1
        FROM dbo.Hierarchy h
        JOIN #Queue q ON h.ParentID = q.NodeID
        WHERE q.Level = @CurrentLevel
          AND NOT EXISTS (SELECT 1 FROM #Descendants d WHERE d.NodeID = h.NodeID);

        -- 將新發現的子節點加入佇列供下一輪
        INSERT INTO #Queue (NodeID, Level)
        SELECT h.NodeID, @CurrentLevel + 1
        FROM dbo.Hierarchy h
        JOIN #Queue q ON h.ParentID = q.NodeID
        WHERE q.Level = @CurrentLevel
          AND NOT EXISTS (SELECT 1 FROM #Queue q2 WHERE q2.NodeID = h.NodeID);

        SET @CurrentLevel += 1;
    END

    -- 5. 輸出 (排除根節點自身若不需要)
    SELECT NodeID, NodeName, Level
    FROM #Descendants
    WHERE NodeID <> @RootID
    ORDER BY Level, NodeID;

    DROP TABLE #Queue, #Descendants;
END
GO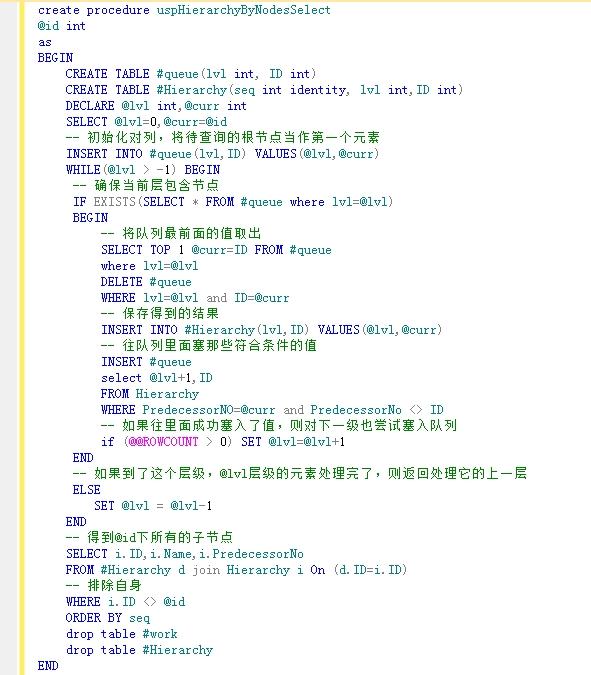
WITH cte AS (
    SELECT NodeID, NodeName, ParentID, 0 AS Level
    FROM dbo.Hierarchy WHERE NodeID = @RootID
    UNION ALL
    SELECT h.NodeID, h.NodeName, h.ParentID, c.Level + 1
    FROM dbo.Hierarchy h JOIN cte c ON h.ParentID = c.NodeID
)
SELECT NodeID, NodeName, Level FROM cte WHERE NodeID <> @RootID
OPTION (MAXRECURSION 0);| 維度 | 佇列 (WHILE + Temp Table) | 遞迴 CTE |
|---|---|---|
| 最大深度限制 | 無 (受限於 tempdb 空間) | 預設 100,可 MAXRECURSION 0 解除 |
| 執行計畫 | 多個迴圈迭代,各自簡單查詢 | 單一查詢計畫,可能產生大型 Spool |
| 大資料量 (10萬+ 節點) | 通常較快,可加索引於 #Queue、#Descendants | 記憶體壓力大,易溢寫 tempdb |
| 平行處理 | 難以平行 | SQL 2014+ 可平行 (Batch Mode) |
| 程式碼複雜度 | 較高 | 簡潔、宣告式 |
Path = '/1/3/5/') 或 Nested Sets 預計算,查詢變單純 LIKE/範圍掃描。