 SQL Server 統計資訊深度解析:查詢優化器的決策基石
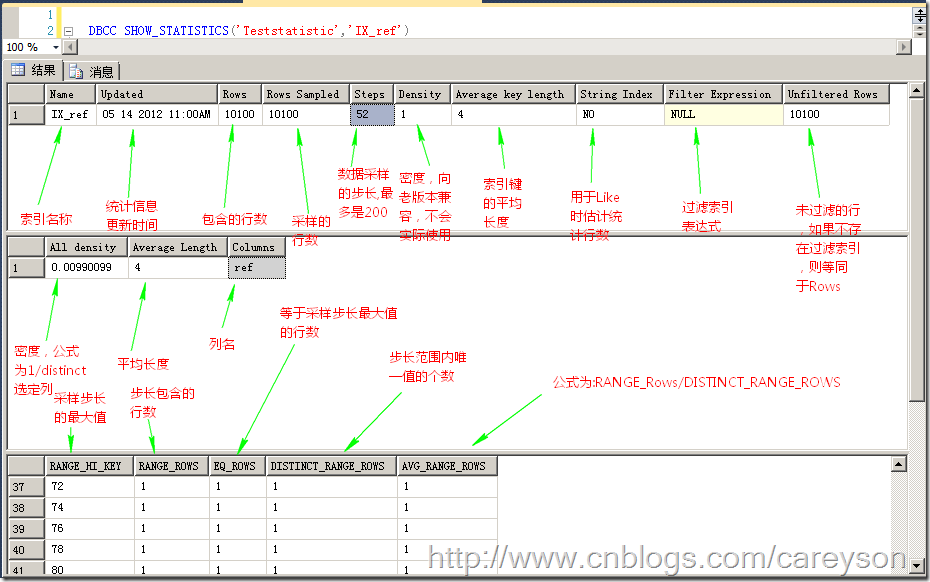
統計資訊:優化器的「眼睛」 查詢優化器不會每次都即時統計索引行數與值分佈,而是依據特定條件建立並更新統計資訊,儲存於資料庫中供決策參考。透過 DBCC SHOW
 SQL Server 執行引擎核心機制圖解:從執行計畫看效能優化
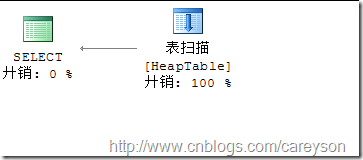
核心觀念:資料存取與組織架構 SQL Server 執行計畫中的每一項操作,都是查詢優化器根據統計資訊與資料分佈所做出的最佳決策。要讀懂執行計畫,首先必須理解資
 INSERT INTO SELECT vs SELECT INTO:核心差異與適用場景全解析
一眼看懂的核心差異 特性INSERT INTO SELECTSELECT INTO 目標表是否需預先存在是(必須先建表)否(自動建表) 可指定插入欄位順序/子
 SQL 性能分析三板斧:STATISTICS IO、SHOWPLAN_ALL、圖形化執行計劃
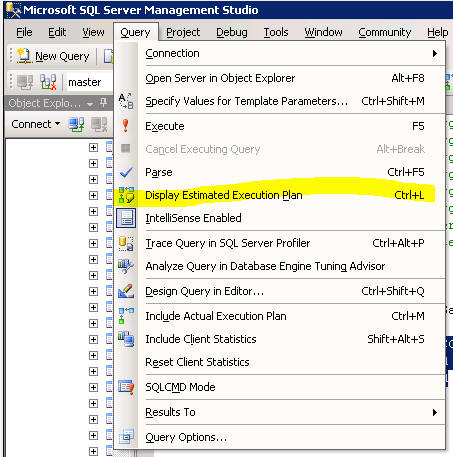
方法 1:SET STATISTICS IO ON SET STATISTICS IO ON; SELECT * FROM BigTable; SET STAT
SQL Server 去重保留一條:MIN(Id) 分組法與 ROW_NUMBER 法對比
測試數據準備 CREATE TABLE TestData( Id INT IDENTITY(1,1) PRIMARY KEY, Data INT
SQL 進階特殊語句筆記:XML 輸出、大批量 XML 導入、類型轉換、STUFF、鄰近查詢、分組取 TopN、聯表刪除
1. FOR XML 輸出 -- AUTO 模式,元素為節點 SELECT LogisticsId, LogisticsName FROM LogisticsC
SQL Server 批量刪除 tempdb 中指定後綴的臨時表
腳本 0 BEGIN SELECT TOP 1 @tbl = name FROM #t; EXEC(IF OBJECT_ID( + @tbl
SQL Server 批量修改標識列:關閉標識、重置種子、腳本化自動化
場景 需在數千台服務器上批量調整自增列種子值(如遷移合併數據後避免主鍵衝突),界面操作不可行,需 T-SQL 腳本配合 Redgate 等工具分發執行。 核心
SQL Server 索引分析與優化實戰腳本合集
核心 DMV 概覽 DMV/函數用途 sys.dm_db_index_physical_stats索引碎片率、頁密度、記錄數 sys.dm_db_missin
SQL Server 秒級統計字串中漢字個數:DATALENGTH 與 LEN 差值法
核心原理 LEN() 返回字元數(雙位元字元計 1)。 DATALENGTH() 返回位元組數(雙位元字元計 2)。 漢字佔 2 位元組,英文/數字/符號佔
SQL Server 去除字串中連續重複分隔符的高效方法
問題場景 數據清洗中常遇到「中 國」這類多連續空格,需壓縮為單一分隔符。本文提供通用 T-SQL 迴圈方案。 代碼實現 0 BEGIN SET @
SQL Server 字串分割最佳實踐:REPLACE + UNION ALL 動態 SQL 方案
核心思路 利用 REPLACE 將分隔符替換為 UNION ALL SELECT ,構造動態 SQL 並執行,無需迴圈、遞歸 CTE 或自定義函數,極簡高效。
SQL Server 高性能漢字轉拼音首字母函數(支援 2 萬+ 常用字)
函數設計目標 輸入任意 NVARCHAR 字串,輸出每個漢字的拼音首字母大寫(非漢字原樣保留)。 覆蓋 Unicode CJK 統一表意字基本區(19968~
SQL Server 字串查找函數 PATINDEX 與 CHARINDEX 深度對比與實戰指南
核心差異一覽 特性CHARINDEXPATINDEX 通配符支援❌ 僅字面字串✅ 支援 %、[]、[^] 等 參數個數2 或 3(可指定起始位置)2(模式必須
 SQL Server 批量導出 master 系統存儲過程為 .sql 腳本文件
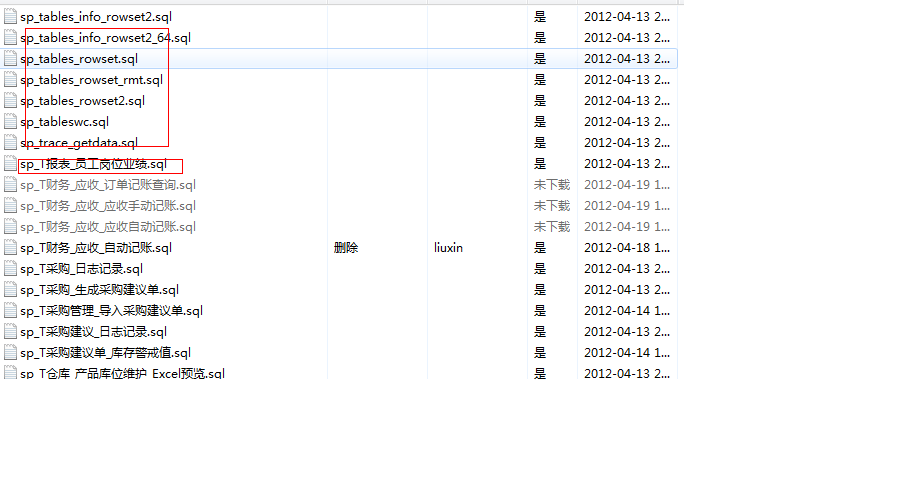
痛點背景 SSMS「生成腳本」無法導出系統存儲過程(標記為系統物件)。若需備份、遷移或分析 master 中的系統存儲過程,需繞過限制。本文提供一個通用存儲過程
SQL Server 字串左對齊/右對齊填充的高效實現
核心函數:REPLICATE REPLICATE(char, count) 重複產生指定字元,配合 LEFT/RIGHT 即可輕鬆實現定寬填充。 代碼示範 D
SQL Server 參數化查詢進階:XML 與表值參數(TVP)實現 WHERE IN 詳解
前言 承接上文,本文聚焦方案 5(XML)與方案 6(TVP)的深度實現細節,包括 XQuery 語法、exist() 與 value() 性能差異、TVP 類
SQL Server 參數化查詢:WHERE IN 與 LIKE 的六大實現方案深度解析
背景痛點 開發中常遇到 WHERE IN 需傳入大量參數(數百至數萬)的場景。直接拼接 SQL 雖簡單,但無法復用執行計劃,且存在注入風險。參數化查詢雖安全,但


