索引是關係型資料庫效能優化的核心機制。本文作為「PL/SQL 性能優化系列」第一篇,系統梳理 Oracle 索引的儲存結構、B-Tree 運作原理、索引類型分類及選擇性原則,為後續優化實戰奠定理論基礎。
Oracle 預設索引為 B-Tree(Balanced Tree),特點:
(Key Value, Rowid) 配對,按鍵值有序排列。| 索引類型 | 特點 | 適用場景 |
|---|---|---|
| B-Tree 索引(預設) | 平衡樹,支援等值、範圍、排序、分組 | 高選擇性欄位、OLTP 核心查詢、主鍵/唯一約束 |
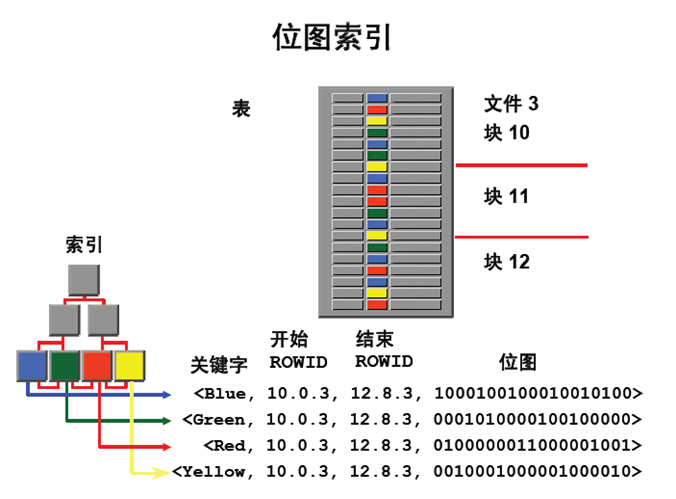
| Bitmap 索引 | 位圖編碼,壓縮儲存,鎖定粒度大 | 低基數欄位(性別、狀態)、數據倉庫、唯讀/批量載入環境 |
| Function-Based 索引 | 儲存函數運算結果 | WHERE 子句含函數運算(如 UPPER(name))、避免隱含轉換 |
| Reverse Key 索引 | 反轉鍵值位元組順序 | 避免單調遞增鍵值(序列號)導致右邊緣爭用 |
| Partitioned 索引 | Local(等分區) / Global(跨分區) | 大表分區表、分區裁剪、維護彈性 |
| Domain 索引 | 擴展索引型別(如 Oracle Text) | 全文檢索、空間數據、多媒體索引 |
Distinct Keys / Num Rows。越接近 1(唯一索引)效果越好;< 0.01 通常不被優化器採用。Blocks 表好,接近 Num Rows 表差。差的 CF 導致索引範圍掃描產生大量隨機 I/O。WHERE num_col = '123'(字串比數字)WHERE UPPER(name) = 'ABC'(無 FBI)(A,B,C),查詢僅 WHERE B=1IS NULL / NOT IN / != / LIKE '%abc' 等無法走 B-Tree 範圍掃描DBMS_STATS.GATHER_TABLE_STATS(..., CASCADE=>TRUE) 收集統計資訊。V$OBJECT_USAGE 識別未使用索引,評估刪除以減輕 DML 開銷。UNUSABLE,載入後 REBUILD,避免索引維護開銷。TRUNCATE PARTITION 自動維護)。下一篇將深入探討 Join 關聯機制(Hash Join、Nested Loops、Sort Merge Join)與 執行計劃分析實戰。