設計目標
SPLIT(str, sep):返回集合型別,可用於 TABLE() 轉行,支援 IN 子查詢。SPLITSTR(str, idx, sep):取第 N 個分割片段,idx=0 返回原串,越界返回 NULL。
型別與函數定義
-- 1. 集合型別
CREATE OR REPLACE TYPE tabletype AS TABLE OF VARCHAR2(32767);

-- 2. SPLIT:PIPELINED 流式返回,記憶體友好
CREATE OR REPLACE FUNCTION split(
    p_list CLOB,
    p_sep  VARCHAR2 DEFAULT ','
) RETURN tabletype PIPELINED IS
    l_idx   PLS_INTEGER;
    v_list  VARCHAR2(32767) := p_list;
BEGIN
    LOOP
        l_idx := INSTR(v_list, p_sep);
        IF l_idx > 0 THEN
            PIPE ROW (SUBSTR(v_list, 1, l_idx - 1));
            v_list := SUBSTR(v_list, l_idx + LENGTH(p_sep));
        ELSE
            PIPE ROW (v_list);
            EXIT;
        END IF;
    END LOOP;
    RETURN;
END;
/

-- 3. SPLITSTR:調用 SPLIT 復用邏輯
CREATE OR REPLACE FUNCTION splitstr(
    str IN CLOB,
    i   IN NUMBER DEFAULT 0,
    sep IN VARCHAR2 DEFAULT ','
) RETURN VARCHAR2 IS
    t_cnt NUMBER;
    t_str VARCHAR2(4000);
BEGIN
    IF i = 0 THEN
        RETURN str;
    ELSIF INSTR(str, sep) = 0 THEN
        RETURN NULL;  -- 原邏輯返回 sep,這裡改為 NULL 更符合直覺
    ELSE
        SELECT COUNT(*) INTO t_cnt FROM TABLE(split(str, sep));
        IF i <= t_cnt THEN
            SELECT column_value INTO t_str
            FROM (SELECT ROWNUM rn, column_value FROM TABLE(split(str, sep)))
            WHERE rn = i;
        END IF;
    END IF;
    RETURN t_str;
END;
/
使用示例
1. SPLIT 配合 TABLE() 轉行
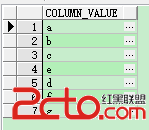
SELECT * FROM TABLE(split('a,b,c,e,d,f,g'));
-- 返回 7 行,每行一個元素

SELECT * FROM TABLE(split('X-rapido&Lemon', '&'));
-- 自定義分隔符
2. 實戰:IN 子查詢動態列表
SELECT * FROM users
WHERE user_id IN (SELECT column_value FROM TABLE(split('1001,1002,1003')));
3. SPLITSTR 取指定片段
SELECT splitstr('X-rapido&Lemon&Jennifer', 1, '&') FROM dual; -- X-rapido
SELECT splitstr('X-rapido&Lemon&Jennifer', 2, '&') FROM dual; -- Lemon
SELECT splitstr('X-rapido&Lemon&Jennifer', 3, '&') FROM dual; -- Jennifer
SELECT splitstr('X-rapido&Lemon&Jennifer', 4, '&') FROM dual; -- NULL
性能與避坑提示
- PIPELINED:逐行產出,避免大集合佔用 PGA。
VARCHAR2(32767):支援最大長度,超長字串請用 CLOB 參數。- 分隔符支援多字符 (如
'||'),INSTR/LENGTH 自動適配。
- 12c+ 可考慮內建
JSON_TABLE 或 XMLTABLE 替代。