Oracle Text 架構概覽
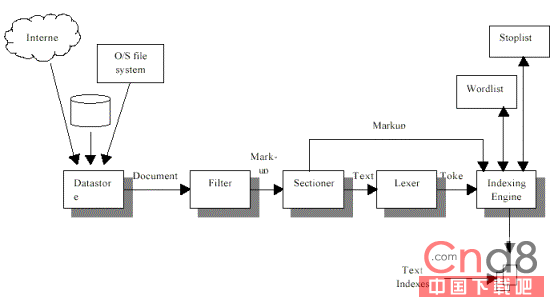
圖 1 Oracle Text 體系架構
索引建立五大邏輯步驟
- 資料存儲:掃描表所有列,讀取資料。部分存儲類型 (如
URL_DATASTORE) 將列值視為指標 (URL)。
- 過濾器:提取文件內容並轉為文本表示。二進制文件 (Word、PDF) 必經此步驟,輸出可為 XML/HTML 等結構化文本。
- 分段器:將過濾器輸出轉為純文本。處理 XML/HTML 標籤、移除不可見資訊、重新格式化文本。不同格式對應不同分段器。
- 詞法分析器:將純文本拆分為離散 Token。空白分隔語言使用標準分析器;亞洲語言 (中/日/韓) 採用專用分析器處理複雜分詞。
- 索引引擎:收集所有 Token、文件區段偏移量、停用詞表,建立倒排索引 (Inverted Index),記錄 Token 與包含該 Token 的文件對應關係。
關鍵組件說明
- DATASTORE:定義資料來源 (直接欄位、檔案系統、URL、自定義程序)。
- FILTER:文件格式轉換 (INSO_FILTER、NULL_FILTER、AUTO_FILTER)。
- SECTIONER:結構化文件區段識別 (HTML_SECTION_GROUP、XML_SECTION_GROUP、AUTO_SECTION_GROUP)。
- LEXER:分詞規則 (BASIC_LEXER、CHINESE_LEXER、JAPANESE_LEXER、KOREAN_LEXER、MULTI_LEXER)。
- WORDLIST:字詞表選項 (前綴索引、子字串索引、模糊匹配、詞幹擴展)。
- STOPLIST:停用詞表,排除低資訊量詞彙。
- STORAGE:索引表儲存參數。
查詢處理流程
- 使用者發出
CONTAINS/CATSEARCH 查詢;
- 查詢解析器依詞法分析器規則拆解查詢字串;
- 索引引擎搜尋倒排索引,定位符合文件;
- 評分演算法計算相關性分數;
- 回傳結果集 (可含片段高亮、評分排序)。
結語
Oracle Text 採用管線式架構,將文件處理標準化為「存儲→過濾→分段→分詞→索引」五階段,每階段皆可透過偏好設定客製化。理解此架構有助於針對特定文件類型、語言與查詢需求調優索引品質與查詢效能。