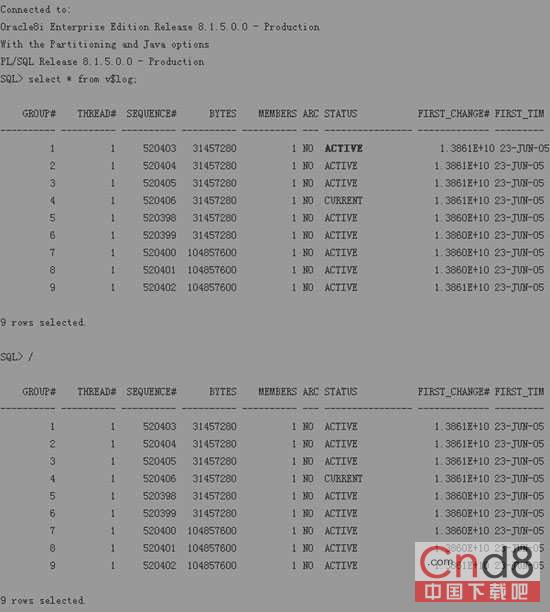
截圖顯示:Group 1 Current、Group 2/3/4 Active、無 Inactive/Unused Group。LGWR 無可寫入 Group,資料庫實質掛起。
LOG_BUFFER 過小導致頻繁切換。Cannot allocate new log、Checkpoint not complete,DBWn 寫入緩慢拖慢切換。
# OS 層刪除/移動舊歸檔
mv /arch/old/*.arc /backup/arch/
# 或 RMAN
RMAN> DELETE ARCHIVELOG ALL COMPLETED BEFORE 'SYSDATE-1';
ALTER SYSTEM SWITCH LOGFILE; -- 可能卡住,需在另一 Session 監控
ALTER DATABASE ADD LOGFILE GROUP 5 ('/u01/oradata/redo05a.log','/u02/oradata/redo05b.log') SIZE 200M;
ALTER DATABASE ADD LOGFILE GROUP 6 ('/u01/oradata/redo06a.log','/u02/oradata/redo06b.log') SIZE 200M;
-- 立即提供 Inactive Group 讓 LGWR 寫入
SELECT process, status, error FROM v$managed_standby WHERE process LIKE 'ARC%';
-- 或查 Alert Log 尾部錯誤
| 維度 | 建議 | 效果 |
|---|---|---|
| Group 數量 | 6~10 組 (視峰值切換頻率) | 增加緩衝窗口 |
| Group 大小 | 1~4 GB (使切換間隔 > 15~30 分鐘) | 降低切換頻率、減輕 ARCn 壓力 |
| 多路歸檔 | LOG_ARCHIVE_DEST_1='LOCATION=/arch1', _2='LOCATION=/arch2', _3='SERVICE=standby' | 單點故障不影響主庫 |
| ASM / Fast Recovery Area | 啟用 FRA (DB_RECOVERY_FILE_DEST) 自動管理空間與清理 | 自動清理舊歸檔、防止磁碟滿 |
| Standby Redo Log (Data Guard) | 備庫配置 SRL,同步傳輸降低主庫歸檔壓力 | 零資料遺失、分擔歸檔 I/O |
| 監控告警 | 每 1 分鐘檢查 V$LOG Active Group 數 > 3 即告警 | 分鐘級發現、秒級響應 |
LOG_ARCHIVE_DEST_n 失效自動切換。LOG_ARCHIVE_DEST_n ALTERNATE 參數、Snapshot Standby。Redo Log 全 Active 是 **「產生 > 消費」的經典瓶頸**。緊急處理:**加 Group、清空間、查 ARCn**;長效治理:**加大 Group、多路歸檔、啟用 FRA、升級版本、建立監控**。記住:**Redo 是資料庫生命線,LGWR 停寫 = 業務停擺**,容不得半點馬虎。